들어가며
장애 조사에서 가장 먼저 하는 일은 "최근에 무엇이 바뀌었나"를 확인하는 것이다. 대부분의 장애는 변경에서 온다.
그런데 이번에는 아무것도 바뀌지 않았다. 배포도 없었고, 설정 변경도 없었고, 감사 로그에도 변경 기록이 없었다. 그런데 서비스는 기동조차 못 하고 있었다.
원인은 한 달 전에 중간까지만 진행한 작업이었다. 그 작업은 끝난 것처럼 보였고, 한 달 동안 아무 증상도 없었다. 이 글은 그 한 달의 침묵이 어떻게 만들어졌는지에 대한 기록이다.
증상
ECS 클러스터에서 운영 중인 서비스의 Task가 기동 직후 크래시하며 crash loop에 진입했다. CloudWatch 로그에는 Spring Boot 기동 실패(Application run failed)가 기록되었고, ECS 이벤트에서 Task 시작 → 등록 → drain → deregister가 반복되었다.
RedisWrongPasswordException: WRONGPASS invalid username-password pair
or user is disabled.
Redis(Valkey) 인증 실패로 인해 Bean 생성 체인이 연쇄적으로 실패했다.
redissonClient → redissonConnectionFactory → stringRedisTemplate
→ JwtBlacklistService → jwtValidationCache → jwtAuthenticationFilter
→ Tomcat 기동 불가
JWT 블랙리스트를 Valkey에 저장하는 구조였기 때문에, Valkey 연결 실패가 곧 서비스 전체 기동 실패로 이어졌다.
조사 과정
CloudTrail + Athena 감사 로그 분석
누군가 비밀번호를 변경했거나, 인프라 설정이 바뀌었을 가능성을 먼저 확인했다.
| 조사 항목 | 결과 |
|---|---|
Secrets Manager 변경 이력 (PutSecretValue, UpdateSecret) | 없음: GetSecretValue만 존재 |
| ElastiCache API 변경 이력 | 없음 |
ECS 새 배포 (RegisterTaskDefinition, UpdateService) | 없음 |
ECR 이미지 push (PutImage) | 없음 |
CloudTrail 분석 결과, 최근 어떤 변경도 발생하지 않았다. 비밀번호가 바뀐 것도, 새 배포가 된 것도, 이미지가 푸시된 것도 아니었다.
인프라 상태 확인
| 항목 | 상태 |
|---|---|
| Valkey Replication Group | available, 정상 |
AuthTokenEnabled | true (AUTH TOKEN 방식) |
AuthTokenLastModifiedDate | 약 한 달 전 |
| ElastiCache 이벤트 | 스냅샷 성공만 존재, 페일오버/유지보수 없음 |
| Task Definition | 변경 없음 |
| Secrets Manager 저장값 | 정상 존재 |
모든 것이 정상이었지만, 한 가지 단서가 있었다, AUTH TOKEN의 마지막 수정일이 약 한 달 전이었다.
원인 특정
Secrets Manager에 저장된 비밀번호로 AUTH TOKEN을 재설정(SET) 시도했을 때 결정적인 에러가 발생했다.
InvalidParameterValue: The AUTH token provided does not match the AUTH token
provided for rotation. To SET, please use an AUTH token that is the same as
the AUTH token provided for rotation.
이 에러는 AUTH TOKEN 로테이션이 중간 상태에서 멈춰 있다는 것을 의미한다.
근본 원인
Secrets Manager ↔ ElastiCache 관계
┌─────────────────────┐     ┌──────────────────────┐     ┌─────────────────────┐
│  Secrets Manager    │     │  ECS Task            │     │  ElastiCache Valkey │
│                     │     │                      │     │                     │
│  [secret-path]      │──①──│  REDIS_PASSWORD      │──②──│  AUTH TOKEN         │
│                     │     │  (환경변수로 주입)    │     │  (인증에 사용)      │
│                     │     │                      │     │                     │
│  {"password":"xxx"} │     │  값: "xxx"           │     │  허용 토큰: "yyy"   │
└─────────────────────┘     └──────────────────────┘     └─────────────────────┘
        ↑                                                         ↑
        │              자동 동기화 없음 - 수동 관리 필요            │
        └──────────────────────────────────────────────────────────┘

문제: "xxx" ≠ "yyy" → WRONGPASS
Secrets Manager와 ElastiCache AUTH TOKEN 사이에는 자동 동기화가 없다. ElastiCache "간편한 생성"으로 Valkey를 만들 때 자동 생성된 AUTH TOKEN과, Secrets Manager에 수동으로 저장한 비밀번호가 처음부터 달랐다.
"간편한 생성" 시 AUTH TOKEN이 자동 생성되지만 그 값을 다시 확인할 방법이 없으므로, 생성 직후 반드시 AUTH TOKEN을 원하는 값으로 변경하고 Secrets Manager와 동기화해야 한다.
ElastiCache AUTH TOKEN 변경 프로세스
ElastiCache의 AUTH TOKEN 변경은 2단계로 이루어진다.
정상 절차:
  ROTATE (새 비밀번호 추가) → SET (기존 비밀번호 제거, 새 비밀번호 확정)
ROTATE 단계에서는 기존 비밀번호와 새 비밀번호가 동시에 유효하다. 이후 SET을 실행해야 기존 비밀번호가 제거되고 새 비밀번호만 남는다.
실제 발생한 상황
ROTATE 실행 (새 비밀번호 추가) → SET 미실행 (로테이션 중간 상태 방치)
약 한 달 전 AUTH TOKEN 변경 작업 시 ROTATE만 실행하고 SET을 실행하지 않은 채 방치되었다.
왜 한 달간 문제가 없었는가
기존 Task들은 이미 Valkey에 연결된 상태였기 때문에 재인증이 필요하지 않았다. 인증은 연결을 맺을 때 한 번 일어나고, 그 뒤로는 같은 커넥션을 계속 재사용한다. Redis 클라이언트는 보통 커넥션 풀을 유지하므로, 한 번 붙은 연결은 프로세스가 살아 있는 동안 유지된다.
[인증이 일어나는 시점]
Task 시작 → 커넥션 생성 → AUTH 1회 → 이후 재사용 (재인증 없음)

[그래서]
설정이 틀려도 실행 중인 Task는 모른다
다음 커넥션이 생길 때 비로소 검증된다
즉 이 시스템은 한 달 동안 "정상"이었던 게 아니라, 검증을 한 번도 하지 않은 상태였다. 커넥션 재사용은 성능을 위한 설계인데, 이 경우에는 잘못된 설정을 한 달간 덮어주는 역할을 했다.
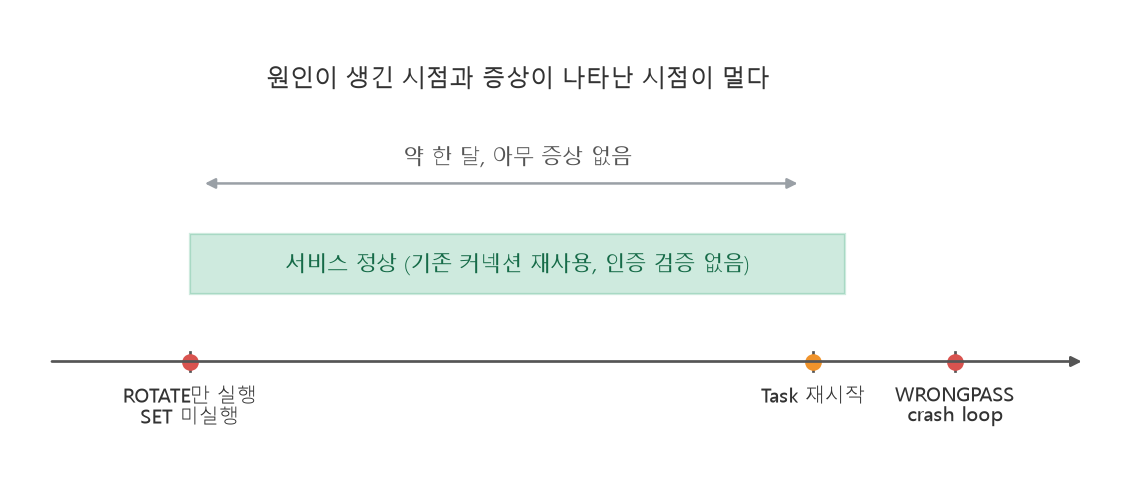
이런 유형의 장애는 원인이 발생한 시점과 증상이 나타난 시점이 멀리 떨어져 있어서, 평소의 조사 방식(최근 변경 확인)으로는 원인에 닿지 못한다.
장애 트리거
[약 한 달 전]     ElastiCache "간편한 생성"으로 Valkey 생성
                  → AUTH TOKEN 자동 생성 (값 확인 불가)
                  → Secrets Manager에 별도 비밀번호 수동 저장
                  → 두 값이 다른 상태로 운영 시작

[약 한 달간]      task 재시작 없이 장기 운영
                  → persistent connection 유지 → 문제 미발견

[장애 당일 새벽]   Valkey 스냅샷 윈도우 실행

[장애 당일 오전]   Task 재시작 (ECS 내부 스케줄링 또는 인프라 이벤트)
                  → 새 Task가 Secrets Manager 비밀번호로 AUTH 시도
                  → AUTH TOKEN 불일치 → WRONGPASS
                  → Spring Boot 기동 실패
                  → ECS crash loop 진입
핵심은 로테이션 중간 상태가 한 달간 방치되었고, Task 재시작이 트리거가 되어 장애가 발생한 것이다.
복구 과정
Step 1: ROTATE로 Secrets Manager 비밀번호를 다시 유효하게 추가
aws elasticache modify-replication-group \
  --replication-group-id [replication-group-id] \
  --auth-token "[password]" \
  --auth-token-update-strategy ROTATE \
  --apply-immediately
Step 2: available 상태 확인 후 SET으로 확정
# 상태 확인 (available 될 때까지 대기)
aws elasticache describe-replication-groups \
  --replication-group-id [replication-group-id] \
  --query "ReplicationGroups[0].Status" --output text

# SET 실행 - 로테이션 완료
aws elasticache modify-replication-group \
  --replication-group-id [replication-group-id] \
  --auth-token "[password]" \
  --auth-token-update-strategy SET \
  --apply-immediately
Step 3: ECS 서비스 강제 재배포
aws ecs update-service \
  --cluster [cluster-name] \
  --service [service-name] \
  --force-new-deployment
ROTATE → SET → ECS 재배포 순서로 진행하여 서비스가 정상 복구되었다.
재발 방지
AUTH TOKEN 변경 시 필수 절차
| 단계 | 작업 | 확인 사항 |
|---|---|---|
| 1 | ROTATE 실행 | 새 비밀번호 추가 (기존 + 새 비밀번호 둘 다 유효) |
| 2 | 애플리케이션 연결 확인 | 새 비밀번호로 정상 연결되는지 검증 |
| 3 | SET 실행 | 기존 비밀번호 제거, 새 비밀번호만 유효 |
| 4 | Secrets Manager 업데이트 | 저장된 비밀번호를 새 값으로 변경 |
| 5 | ECS force new deployment | Task 재시작하여 새 비밀번호로 연결 확인 |
신규 생성 직후 동기화 절차
ElastiCache "간편한 생성" 후 AUTH TOKEN이 자동 생성되지만 확인할 방법이 없으므로, 원하는 비밀번호로 덮어써야 한다:
# (1) 원하는 비밀번호를 ROTATE로 추가
aws elasticache modify-replication-group \
  --replication-group-id [replication-group-id] \
  --auth-token "[password]" \
  --auth-token-update-strategy ROTATE \
  --apply-immediately

# (2) available 대기 후 SET으로 확정 (기존 자동 생성 토큰 제거)
aws elasticache modify-replication-group \
  --replication-group-id [replication-group-id] \
  --auth-token "[password]" \
  --auth-token-update-strategy SET \
  --apply-immediately

# (3) Secrets Manager에 같은 비밀번호 저장
aws secretsmanager put-secret-value \
  --secret-id "[secret-name]" \
  --secret-string '{"password":"[password]"}'

# (4) ECS 서비스 재배포
aws ecs update-service \
  --cluster [cluster-name] \
  --service [service-name] \
  --force-new-deployment
동기화 상태 확인 방법
Bastion에서 Secrets Manager 비밀번호로 직접 연결 테스트:
redis-cli -h [valkey-endpoint] -p 6379 --tls -a '[password]'
# PONG → 동기화 정상
# WRONGPASS → 불일치 → 위 동기화 절차 수행 필요
핵심 교훈
ROTATE후 반드시SET으로 완료할 것, 중간 상태 방치는 시한폭탄- AUTH TOKEN 변경과 Secrets Manager 업데이트는 반드시 한 세트로 처리
- 기존 커넥션이 유지되는 동안은 문제가 드러나지 않으므로, 변경 직후 Task를 재시작하여 새 비밀번호로 연결을 검증해야 함
- CloudTrail + Athena 감사 로그는 "변경이 없었다"는 사실을 확인하는 데에도 유용함, 소거법의 핵심 도구
같은 유형이 또 있는가
이 장애를 겪고 나서 같은 구조를 가진 항목을 찾아봤다. 조건은 세 가지다.
- 설정을 바꿔도 실행 중인 프로세스에는 즉시 반영되지 않는다
- 다음 재시작이나 만료 시점에 처음 검증된다
- 그 시점이 우리가 고르는 게 아니라 외부 사건(배포, 스케일 아웃, 플랫폼 패치)으로 정해진다
| 항목 | 언제 드러나나 | 미리 확인하는 방법 |
|---|---|---|
| Secrets Manager의 값 변경 | Task 재시작 시 | 변경 직후 의도적으로 재배포해서 검증 |
| 인증서 갱신 | 만료 시점 또는 재기동 시 | 만료일 알림, 갱신 후 연결 테스트 |
| IAM 정책 축소 | 해당 권한을 실제로 쓰는 순간 | 적용 전 CloudTrail로 사용 이력 확인 |
| AMI와 부팅 스크립트 변경 | 인스턴스 교체 시 | 교체 주기와 무관하게 주기적으로 한 대 재기동 |
공통 해법은 하나다. 검증 시점을 외부 사건에 맡기지 않고, 변경 직후에 우리가 직접 만든다. 토큰을 바꿨으면 그 자리에서 Task를 한 번 재시작해본다. 그러면 한 달 뒤가 아니라 지금 실패한다. 지금 실패하는 편이 훨씬 싸다.
EC2 복원 가이드에서 복구 절차를 미리 밟아보자고 한 것도, AMI 갱신 계획에서 백업의 생성 시점을 따진 것도 같은 생각에서 나왔다.
정리
- ElastiCache AUTH TOKEN 로테이션 미완료(ROTATE만 실행, SET 미실행)가 근본 원인
- 기존 커넥션이 유지되는 동안 약 한 달간 문제가 잠복
- Task 재시작 시 새 커넥션에서 인증 실패 → 서비스 crash loop
- CloudTrail 감사 로그로 최근 변경 없음을 확인하여 원인 범위를 좁힘
- ROTATE → SET → Secrets Manager 업데이트 → ECS 재배포로 복구
배운 점
한 달 전에 한 작업이 오늘의 장애 원인이 될 수 있다. 토큰 로테이션을 ROTATE까지만 하고 SET을 하지 않았는데, 기존 커넥션이 살아 있는 동안에는 아무 일도 일어나지 않았다. 문제는 조용히 기다리다가 Task가 재시작되는 순간 드러났다. 장애 조사의 기본 전제인 "최근 변경을 의심한다"가 여기서는 오히려 원인에서 멀어지게 만들었다.
정상으로 보이는 것과 검증된 것은 다르다. 한 달 동안 서비스는 정상이었지만, 그 정상은 아무도 인증을 다시 시도하지 않아서 얻은 결과였다. 이걸 알고 나서 "지금 잘 돌아간다"는 말을 예전만큼 믿지 않게 됐다. 무엇이 검증되고 있고 무엇이 검증되지 않고 있는지를 나눠 보게 됐다는 게 이 장애의 가장 큰 소득이다.
절차가 두 단계 이상이면 중간에서 멈출 수 있다. 그래서 절차서의 마지막 항목은 작업이 아니라 확인이어야 한다. 로테이션처럼 완료 여부가 즉시 드러나지 않는 작업일수록 그렇다. 이 구조를 정리한 글이 ElastiCache 접속 보안 구조다.
"변경이 없었다"를 확인하는 것도 조사다. CloudTrail로 범위를 좁힐 수 있었던 건 감사 로그를 미리 쌓아두었기 때문이다. 있는 것을 찾는 데만 쓰는 줄 알았던 도구가 없는 것을 증명하는 데 더 크게 쓰였다. 그 환경은 CloudTrail + Athena 감사 로그 분석 환경 구축에 정리해 뒀다.
이어 읽기
- ElastiCache 접속 보안 구조: AUTH Token + TLS 이중 보안: 이 토큰이 쓰이는 보안 구조
- 사내 통합 포털의 Redis(Valkey) 사용 구조: 장애가 난 서비스의 Redis 활용 방식
- AWS CloudTrail + Athena 감사 로그 분석 환경 구축: 원인 범위를 좁히는 데 쓴 감사 환경