배경
NLB에 Target Group이 7개(9443, 8443, 9090, 8090, 4012, 2053, 8083) 붙어 있었다. 오래된 것도 섞여 있어서 쓰지 않는 게 있으면 정리하고 싶었다.
그런데 지우려면 먼저 답해야 하는 질문이 있다. "이거 지금 아무도 안 쓰는 게 맞나?" 인프라에서 삭제가 어려운 이유는 삭제 자체가 아니라 이 확인이 안 되기 때문이다. 확신이 없으면 아무도 손대지 않고, 그래서 쓰지 않는 리소스가 계속 남는다.
단순한 확인이라고 생각했는데 생각보다 쉽지 않았다.
시도한 방법과 실패
| 방법 | 결과 | 원인 |
|---|---|---|
| CloudWatch 메트릭 (ProcessedBytes, NewFlowCount) | Target Group별 데이터 없음 | NLB는 TG별 트래픽 메트릭을 발행하지 않음 (LB 전체 레벨만 존재) |
| NLB 액세스 로그 (레거시 S3) | TLS 리스너만 지원 | 해당 NLB는 전체 TCP 리스너 (TLS 없음) |
| NLB 액세스 로그 (CloudWatch 통합) | 로그 미생성 | TCP 리스너는 NLB_ACCESS_LOGS 미지원 |
왜 NLB는 이걸 안 보여주나
ALB를 쓰다가 NLB로 오면 당황하게 되는 지점이다. ALB에서는 요청 단위 액세스 로그가 당연하게 남는데, NLB에는 없다.
둘이 트래픽을 다루는 방식이 다르기 때문이다.
[ALB, L7]
클라이언트 --- 연결 ---> ALB --- 새 연결 ---> 타겟
ALB가 HTTP 요청을 해석하고 대신 전달한다
→ 경로, 상태 코드, 응답 시간 같은 요청 단위 정보가 남는다

[NLB, L4]
클라이언트 ------- 흐름 전달 -------> 타겟
NLB는 TCP 흐름을 넘길 뿐 내용을 해석하지 않는다
→ 남길 "요청"이라는 단위 자체가 없다
NLB는 내용을 보지 않는 것이 설계 목표다. 그 덕분에 빠르고 프로토콜을 가리지 않지만, 대신 관측할 수 있는 정보도 얇아진다. TLS 리스너에서만 액세스 로그가 나오는 이유도 같은 맥락이다. TLS를 종료하는 경우에만 NLB가 연결에 개입하기 때문이다.
관리형 서비스는 편한 대신, 관측 범위도 서비스가 정해준 만큼만 주어진다.
시도했다가 쓰지 않게 된 리소스는 정리했다.
| 리소스 | 조치 |
|---|---|
| NLB 액세스 로그 배포 (S3, CloudWatch) | 삭제 |
| S3 버킷 (NLB 액세스 로그용) | 삭제 |
| CloudWatch Log Group (NLB 액세스 로그용) | 삭제 |
해결: 계층을 한 칸 내려간다
NLB가 안 보여준다면, 그 트래픽이 실제로 지나가는 곳을 보면 된다. NLB도 결국 ENI를 통해 패킷을 주고받고, ENI 레벨의 기록은 VPC Flow Logs로 남길 수 있다.
NLB ENI → VPC Flow Logs → S3 (JSON 로그) → Athena (SQL 분석)
로드밸런서라는 추상화에는 포트별 트래픽이라는 개념이 없지만, 그 아래 네트워크 계층에는 "어느 목적지 포트로 몇 개의 흐름이 갔는가"가 그대로 남아 있다. 보고 싶은 정보가 상위 계층에 없으면, 같은 사실이 아래 계층에 다른 형태로 남아 있는지 찾는다.
VPC Flow Logs 설정
| 항목 | 설정값 |
|---|---|
| 대상 ENI | NLB에 연결된 ENI |
| 트래픽 유형 | ALL (인바운드 + 아웃바운드) |
| 집계 간격 | 60초 |
| 로그 대상 | S3 |
Flow Logs는 트래픽 경로에 끼어들지 않는다. 패킷을 복사해 기록만 하므로 NLB 동작에 영향을 주지 않는다는 점이, 운영 중인 로드밸런서에 적용할 때 중요했다.
Athena 분석 환경
기존에 CloudTrail 분석용으로 구축해둔 Athena 환경(cloudtrail-analysis Workgroup)을 그대로 활용했다. VPC Flow Logs 전용 테이블만 추가로 만들었고, Partition Projection을 적용해 날짜별 파티션이 자동으로 관리되게 했다.
| 쿼리명 | 용도 |
|---|---|
create-vpc-flow-logs-table | 테이블 생성 (최초 1회만 실행) |
nlb-[lb-name]-port-traffic | 확인 대상 7개 포트의 트래픽 요약 |
nlb-[lb-name]-all-ports | 전체 포트 중 트래픽 상위 20개 |
결과는 listener_port(= Target Group 포트), connection_count, total_packets, total_bytes, unique_sources 컬럼으로 정리했다. 고유 소스 IP 수를 같이 본 이유는, 연결 수가 적어도 여러 곳에서 오고 있다면 함부로 지울 수 없기 때문이다.
확인 결과
약 1~2시간 데이터 기준이다.
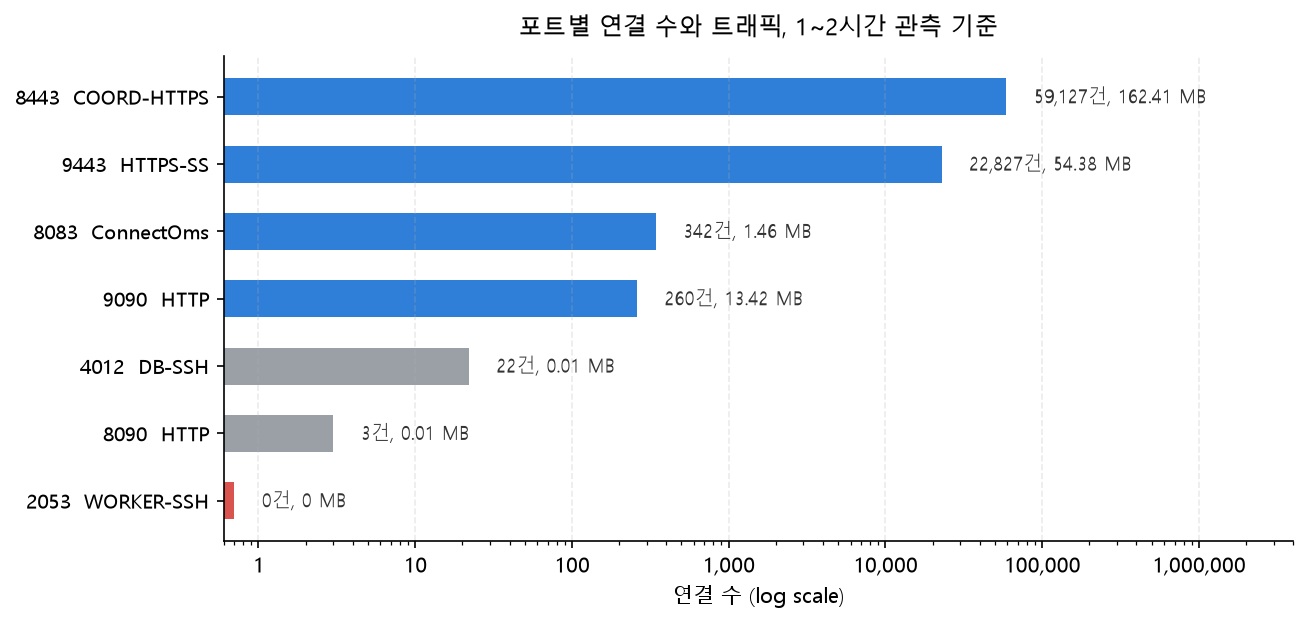
| 포트 | Target Group | 연결 수 | 트래픽 | 판정 |
|---|---|---|---|---|
| 8443 | COORD-HTTPS | 59,127 | 162.41 MB | 활발히 사용 중 |
| 9443 | HTTPS-SS | 22,827 | 54.38 MB | 활발히 사용 중 |
| 9090 | HTTP | 260 | 13.42 MB | 사용 중 (소량) |
| 8083 | ConnectOms | 342 | 1.46 MB | 사용 중 (소량) |
| 4012 | DB-SSH | 22 | 0.01 MB | 거의 없음 |
| 8090 | HTTP | 3 | 0.01 MB | 거의 없음 |
| 2053 | WORKER-SSH | 0 | 0 | 트래픽 없음 |
연결 수는 세 자릿수 이상 차이가 나서, 상위와 하위의 구분은 명확했다. 흥미로운 건 9090처럼 연결 수는 적은데 트래픽은 적지 않은 경우다. 연결 하나가 오래 유지되면서 데이터를 많이 주고받는 종류라서, 연결 수만 봤으면 잘못 판단했을 것이다.
이 숫자로 지워도 되는가
여기서 한 번 멈춰야 했다. 1~2시간은 짧다.
- SSH 포트(4012, 2053)는 사람이 필요할 때만 쓴다. 관측 시간에 아무도 접속하지 않았다는 사실이 "쓰지 않는다"를 뜻하지 않는다
- 배치성 연동은 특정 시간대나 특정 요일에만 움직인다
- Flow Logs는 활성화 이후 데이터만 남는다. 과거를 소급해서 볼 수 없다
그래서 결론을 "삭제"가 아니라 관측 기간을 늘려서 다시 보기로 잡았다. 며칠에서 한 주를 지켜보고, 그래도 0이면 바로 지우는 대신 Target Group에서 타겟을 먼저 떼거나 태그로 표시해두고 문의가 오는지 본다. 되돌리기 쉬운 순서로 밟는 편이 안전하다.
비용
| 항목 | 예상 비용 |
|---|---|
| VPC Flow Logs 수집 (S3) | $0.089/GB |
| S3 저장 | $0.025/GB/월 |
| Athena 쿼리 | 스캔 1TB당 $5 (소규모 쿼리는 거의 무료) |
확인이 끝나면 Flow Logs를 꺼서 비용을 줄일 수 있다. 다만 끄는 순간부터 기록이 남지 않으므로, 나중에 같은 질문이 또 나올 것 같으면 켜둔 채로 보존 기간만 짧게 잡는 쪽이 낫다.
정리
- NLB의 TCP 리스너에서는 CloudWatch 메트릭이나 액세스 로그로 Target Group별 트래픽을 확인할 수 없다
- NLB가 L4에서 흐름을 전달만 하기 때문에 요청 단위 기록이 애초에 생기지 않는다
- VPC Flow Logs는 ENI 레벨에서 같은 사실을 남기고, 트래픽 경로에 영향을 주지 않는다
- 기존 Athena 환경을 재사용하면 추가 인프라 없이 분석할 수 있다
- 관측 기간이 짧으면 "트래픽 0"은 미사용의 근거가 되지 못한다
배운 점
추상화가 감춘 정보는 한 계층 아래에 있다. 로드밸런서라는 이름 위에서는 답이 없던 질문이, 네트워크 인터페이스 레벨에서는 이미 기록되어 있었다. 관리형 서비스에서 막히면 "이 서비스는 못 한다"가 아니라 "이 사실이 어디에 남는가"를 묻는 게 빠르다.
지우기 위해 필요한 건 권한이 아니라 근거였다. Target Group 삭제는 클릭 몇 번이지만, 아무도 실행하지 못한 이유는 확인 수단이 없었기 때문이다. 정리가 안 되는 인프라는 대개 게을러서가 아니라 관측이 없어서 그렇게 된다.
없다는 결론은 있다는 결론보다 더 많은 데이터를 요구한다. 트래픽이 있다는 건 한 건만 봐도 증명되지만, 없다는 건 충분히 긴 기간을 봐야 말할 수 있다. 1~2시간 데이터로 삭제까지 가지 않은 게 이 작업에서 가장 중요한 판단이었다. 같은 이유로 EDI Agent 중앙 모니터링에서도 한 번의 실패가 아니라 연속 실패를 기준으로 삼았다.
여기서 재사용한 분석 환경은 CloudTrail + Athena 감사 로그 분석 환경 구축에 정리해 뒀다.
이어 읽기
- AWS CloudTrail + Athena 감사 로그 분석 환경 구축: 여기서 재사용한 분석 환경
- NLB Target Group Unhealthy 원인 분석 및 해결: 같은 NLB에서 다뤘던 헬스 체크 문제
- EDI Agent 중앙 모니터링 시스템 구축 (AgentMonitor): 관측 기간과 판정 기준을 정한 다른 사례