들어가며
파인튜닝 라운드를 반복하다 보면 매번 F1을 측정하게 된다. 그런데 어느 날 표를 정리하다 이상한 점을 발견했다.
| 체크포인트 | F1 | 측정 기준 |
|---|---|---|
| checkpoint-9240 | 97.41% | 45건 학습 데이터의 내부 test split |
| checkpoint-2866-pv | 97.73% | 300건 학습 데이터의 내부 test split |
두 숫자는 다른 시험지로 본 점수였다. 97.41%와 97.73%를 나란히 놓고 "좋아졌다"고 말할 수 없었다.
더 큰 문제는 따로 있었다. 새 라운드가 기존 능력을 깎아먹었는지(catastrophic forgetting) 알 방법이 없다는 것이다.
고정 벤치마크: 같은 시험지로 재기
해법은 단순하다. 절대 학습에 쓰지 않는 문서 세트를 따로 두고, 매 라운드 후 같은 세트로 측정하는 것이다.
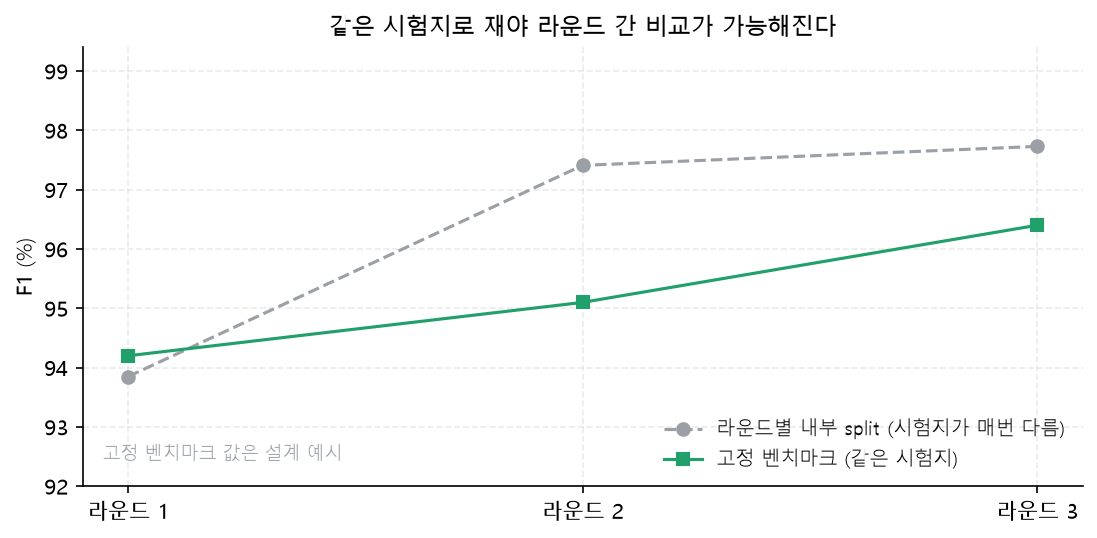
설계는 이렇게 잡았다.
| 항목 | 내용 |
|---|---|
| 규모 | 30~50건 |
| 다양성 | 발행처별 + 문서 유형별(Invoice/BL/detention) + 언어별(영어/스페인어) |
| 경로 커버 | OCR 경로용과 XML 경로용을 각각 포함 |
| 관리 규칙 | 학습 데이터와 물리적으로 분리 보관, export 시 혼입 금지 |
| 측정 시점 | 매 파인튜닝 라운드 완료 직후 |
측정 조건도 함께 동결
시험지만 고정해서는 부족했다. 측정 조건이 바뀌면 같은 시험지라도 점수가 달라지기 때문이다.
# benchmark_eval.py 내 EVAL_CONFIG_VERSION 구역 (동결)
CAP         = 400
OVERLAP     = 10
MAX_SEQ_LEN = 510
운영 스크립트의 청킹 파라미터가 바뀌어도 평가 스크립트는 그대로 둔다. 조건을 바꿔야 하면 버전을 올리고, 이전 버전으로 잰 값과는 비교 불가로 취급한다.
경로별로도 나눠 기록했다. 같은 문서라도 OCR 경로와 XML 경로는 단어 분할과 좌표가 다르므로, 정답 라벨도 따로 만들고 F1도 각각 기록한다.
벤치마크가 자라야 할 때
도메인이 늘면 벤치마크도 커져야 한다. 그런데 커지는 순간 "고정"이 깨진다. 이건 데이터 버전 관리로 풀었다.
- 새 도메인 데이터가 들어오면 그중 몇 건을 학습에 넣지 않고 벤치마크로 분리
- 문서를 추가하면 벤치마크 버전을 올린다 (v1 → v2)
- 모든 F1 기록에 벤치마크 버전을 함께 적는다
- 다른 버전 간 F1은 직접 비교하지 않는다
작은 벤치마크를 읽는 법
30~50건이라는 규모는 관리 가능한 크기이지만, 그만큼 한 건의 영향이 크다. 문서 한 건의 결과가 바뀌면 전체 수치가 눈에 띄게 움직인다. 그래서 숫자를 볼 때 두 가지를 구분한다.
- 개선인가, 흔들림인가: 소수점 아래의 변화는 개선으로 읽지 않는다. 같은 방향의 변화가 두 라운드 연속 나타나는지 보는 편이 안전하다
- 전체가 좋아졌나, 특정 유형만 좋아졌나: 전체 F1이 올라도 특정 양식에서 떨어졌다면 그건 다른 문제다. 그래서 유형별로 나눠 기록한다(테스트 설계)
벤치마크를 크게 키우면 이 문제가 줄지만, 대신 학습에 쓸 수 있는 데이터가 줄어든다. 데이터가 귀한 상황에서는 학습에 쓸 것과 판정에 쓸 것 사이의 배분이 그 자체로 결정 사항이 된다.
화면에 보이는 "점수"는 어떻게 만들어지는가
모델 성능 지표와 별개로, 검수 화면에는 필드마다 점수가 뜬다. 사람이 무엇부터 확인해야 하는지 알려주는 값이다.
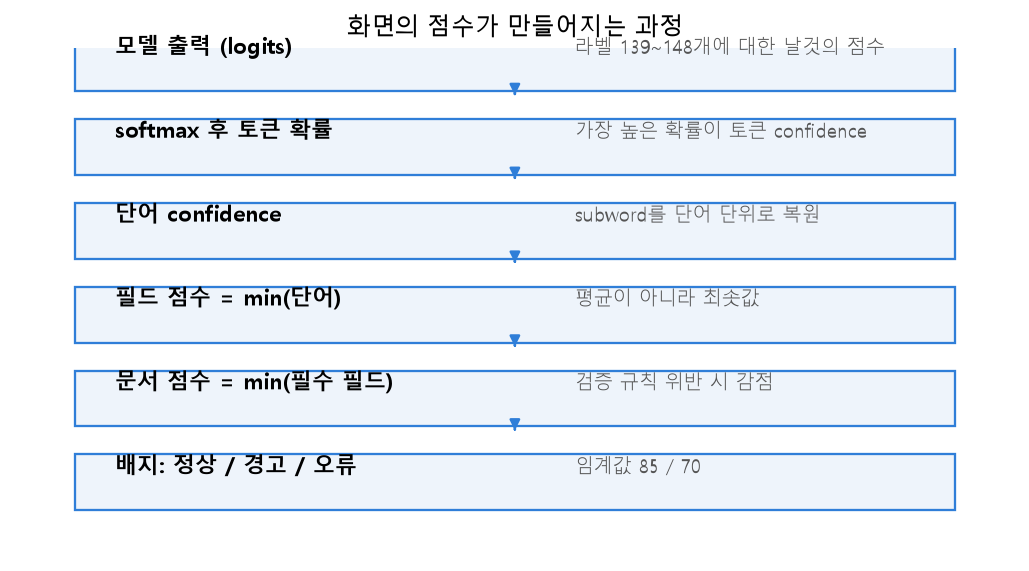
여기서 중요한 결정이 두 개 있었다.
첫째, 필드 점수는 평균이 아니라 최솟값이다. 한 필드가 여러 단어로 이루어질 때, 단어 confidence의 평균을 쓰면 한 단어가 확실히 틀려도 나머지가 가려버린다. 최솟값을 쓰면 "이 필드 안에 불확실한 단어가 하나라도 있으면" 점수가 내려간다. 검수는 틀린 것을 찾는 작업이라 이쪽이 맞았다.
둘째, AI 확신도만으로 점수를 만들지 않았다. 검증 규칙(형식, 필수값, 값 사이의 정합)을 위반하면 감점한다. 그래서 이 값을 "신뢰도"가 아니라 그냥 점수라고 부른다. 모델이 아무리 확신해도 날짜 형식이 깨졌으면 낮은 점수를 줘야 한다.
임계값은 85와 70으로 잡아 정상·경고·오류 배지를 붙였다.
진짜 지표는 검수 수정률
벤치마크 F1은 결국 대리 지표다. 실제로 알고 싶은 건 "운영에서 사람이 얼마나 고치는가"이다.
검수 화면에는 모델이 예측한 값과 사람이 수정한 값이 함께 남는다. 이 둘의 차이가 곧 실전 정확도이고, 워크플로에서 공짜로 나오는 데이터다. 예측값과 수정값을 분리해 저장하도록 설계한 것도 이 때문이다. 수정 이력이 다음 학습 데이터가 되는 구조이기도 하다.
내부 발표로 기준을 맞추기
측정 결과는 사내 발표로 공유했다. 모델 성능뿐 아니라 인스턴스 사양별 처리 속도와 비용 비교도 함께 넣었다.
혼자 측정하고 혼자 판단하면, 나중에 "왜 이 사양을 골랐냐"는 질문에 답할 근거가 개인 메모에만 남는다. 같은 표를 팀이 함께 보면 그다음 결정은 훨씬 빨라진다.
배운 점
측정 기준을 정하는 일이 모델을 고치는 일만큼 중요했다. 라운드마다 다른 시험지를 쓰고 있다는 걸 알아챈 순간, 그동안 쌓아온 F1 표의 절반은 비교용으로 쓸 수 없는 값이 됐다. 지표를 먼저 설계하지 않으면 실험을 아무리 많이 해도 축적되지 않는다.
"조건이 바뀌면 버전이 바뀐다"는 규칙이 유용했다. 평가 조건이든 평가 데이터든 마찬가지다. 이 규칙을 세우고 나서는 숫자를 볼 때 "어느 버전에서 잰 값인가"를 먼저 확인하게 됐다.
점수 정의에는 운영의 관점이 들어가야 했다. 평균 대신 최솟값을 쓰고 검증 규칙 위반을 감점한 건 모델 성능을 잘 보여주기 위해서가 아니라, 검수자가 무엇부터 볼지 정하기 위해서였다. 지표는 누가 어떤 결정을 하려고 보는지에 따라 달라진다는 걸 배웠다.
기준을 고정하는 일은 측정보다 먼저다. 이 생각은 모델에만 해당하지 않았다. 인프라에서도 같은 조건으로 재지 않으면 개선 여부를 말할 수 없다는 걸 MariaDB 이중화 테스트의 Buffer Pool 튜닝에서 확인했다. 무엇을 잴지 정하지 않은 상태의 숫자는 의견에 가깝다.
이어 읽기
- Document AI 성능 측정 체계 구축: OCR부터 MLflow까지: 이 벤치마크의 출발점
- 양식, 언어, 입력 형태로 나눠 테스트한 이유: 평균 뒤에 가려진 약점을 찾는 방법
- 반복 파인튜닝과 망각 방지: 누적 학습과 차등 학습률: 이 기준으로 망각을 판정한 사례
- B-SUPPLIER_NAME은 누가 봐야 하나: BIO 태깅의 경계를 정한 기록: 단어별 신뢰도를 필드 점수로 합치는 정책
- F1이 세 개였다: 같은 이름으로 다른 것을 재고 있었던 기록: 같은 이름의 지표가 서로 다른 것을 재고 있었던 사례
- 실험을 네 개로 나눈 이유: MLflow로 모델 계보와 비교 가능성을 관리한 기록: 평가셋이 다르면 비교가 성립하지 않는 것을 기록으로 막은 방법