들어가며
MLflow를 정비하기 전에는 이런 질문에 답하려면 매번 markdown 문서를 열어야 했다.
"지금 운영에 뭐가 올라가 있고, 문제가 생기면 뭘로 되돌리나?"
실험 목록에는 런이 쌓여 있었지만, 런 이름이 이랬다.
kie__layoutlmv3_ckpt740__project32__api_based_test
이름에 정보를 다 넣은 형태다. 읽을 수는 있는데 검색도 필터도 안 된다. project32로 학습한 런만 보려면 이름 문자열을 눈으로 훑어야 했다. 게다가 성능을 모르는 체크포인트에는 eval_f1 = -1.0이 들어가 있어서, F1 차트를 열면 그래프가 바닥으로 꺾였다.
가장 큰 문제는 따로 있었다. 서로 비교할 수 없는 숫자들이 한 화면에 나란히 있었다.
이 글은 그것을 정리한 기록이다.
한 문장으로
모델 계열마다 실험을 하나씩 두고, 런 이름을 체크포인트 이름으로 쓴다. stage 태그로 운영 상태를, parent_checkpoint로 계보를, eval_set_id로 비교 가능성을 관리한다.
1. 관리 대상이 두 종류다
파이프라인에 학습하는 모델이 둘이다.
문서 이미지
   ↓
PaddleOCR 인식기        ← 글자를 읽는다          (ocr-rec-kor)
   ↓  단어 + 좌표
LayoutLMv3              ← 어떤 필드인지 판단한다  (kie-latin / kie-kor)
   ↓
필드 단위 추출 결과
두 모델은 따로 학습하고 따로 버전이 올라간다. 섞으면 어느 쪽이 좋아졌는지 알 수 없다. OCR과 NER을 파이프라인에서 나눠 고른 이유가 실험 구성에도 그대로 이어진다.
여기에 평가용 실험 하나를 더 뒀다.
| 실험 | 뜻 | 런 |
|---|---|---|
kie-latin | 영문 물류 문서 정보추출 학습 계보 | 9 |
kie-kor | 한글 문서 정보추출 학습 계보 | 3 |
ocr-rec-kor | OCR 인식기 파인튜닝 계보 | 4 |
kie-eval | 평가 전용 | 1 |
kie는 Key Information Extraction이다. LayoutLM이 하는 일이고, ocr-rec은 그 앞단에서 글자를 읽는 인식기다.
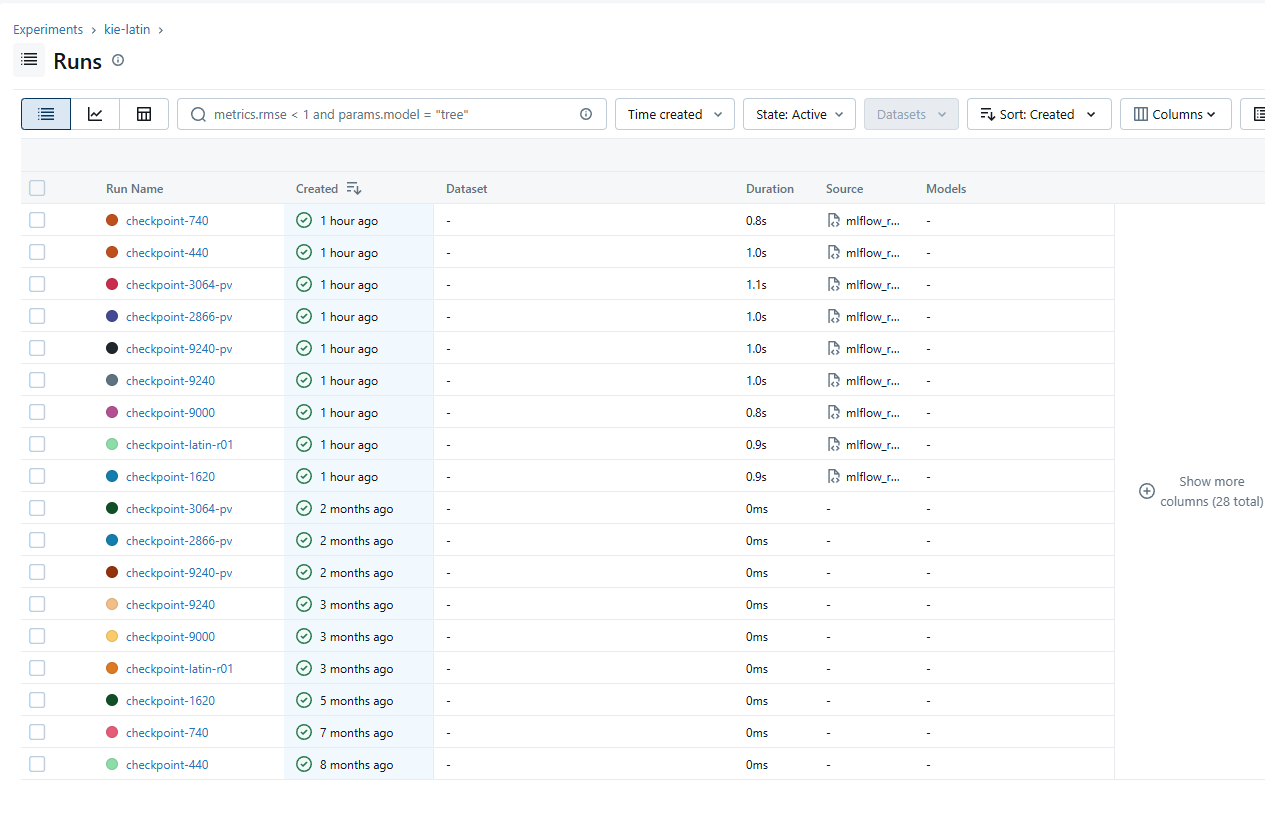
kie-eval을 따로 둔 이유
학습 성적과 실전 성적은 다른 숫자이기 때문이다.
| 측정 대상 | 데이터 | |
|---|---|---|
학습 런의 eval_f1 | 모델만 | 학습 데이터에서 떼어낸 검증셋 |
평가 런의 micro_f1 | OCR + 모델 전체 | 실제 업무 문서 |
채점 단위도 다르다. 학습 쪽은 seqeval로 엔티티 구간을 통째로 맞혀야 점수를 주고, 평가 스크립트는 BIO를 떼고 단어 단위로 센다. 같은 F1이라는 이름으로 서로 다른 것을 재고 있었던 이야기를 따로 정리해 뒀다.
실험을 분리한 것은 두 숫자를 같은 차트에 올릴 수 없게 만드는 장치다. 문서에 "비교하지 마세요"라고 적는 것보다, 구조적으로 못 올리게 하는 쪽이 오래 간다.
2. 기록 규약
| 항목 | 규칙 |
|---|---|
| 런 이름 | 체크포인트 이름 그대로. checkpoint-3064-pv |
| params | checkpoint parent_checkpoint num_labels label_schema train_docs epochs environment eval_set_id date를 모든 런이 가진다. 모르면 "unknown" |
| metrics | 모르면 기록하지 않는다. 자리표시자 금지 |
| tags | stage lang route parent eval_set_id |
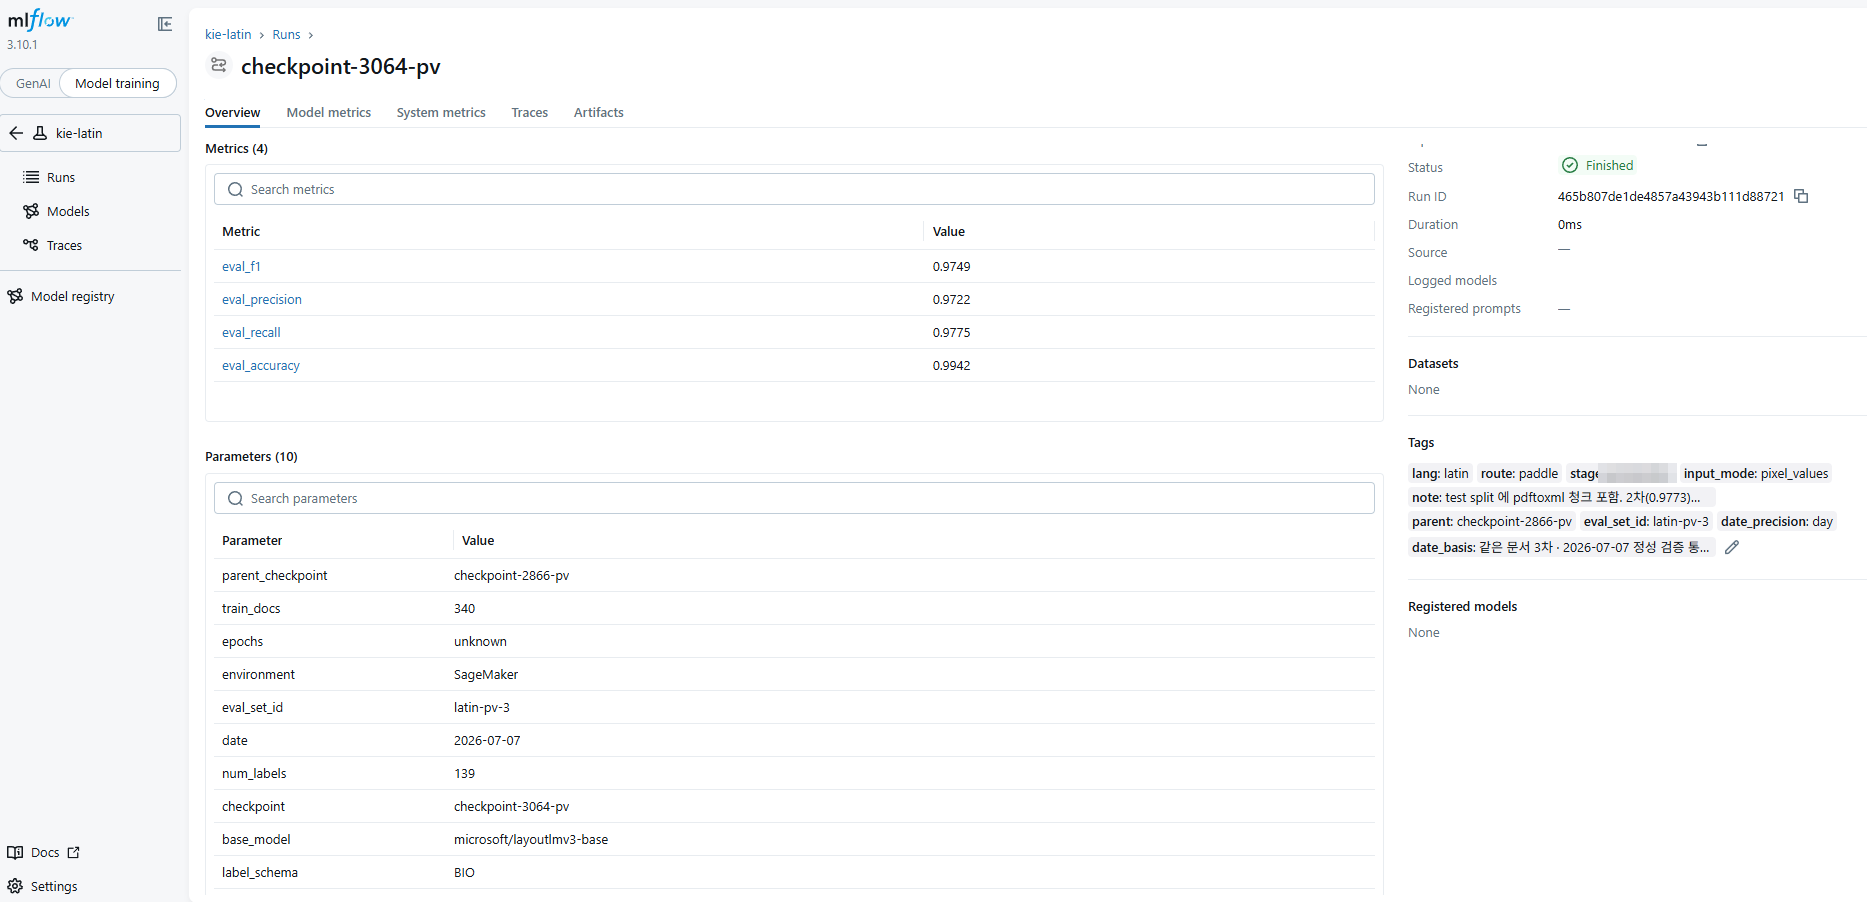
런 이름을 체크포인트 이름으로 바꾼 이유
전 : kie__layoutlmv3_ckpt740__project32__api_based_test
후 : checkpoint-740
앞의 이름은 눈으로만 읽을 수 있다. 정보를 이름에 넣으면 검색도 필터도 안 된다. 이름에는 식별자만 담고 나머지는 params와 tags로 뺐다. 그러면 "route=paddle이면서 stage=production인 런"을 쿼리로 찾을 수 있다.
자리표시자를 쓰지 않는 이유
정비 전에는 성능을 모르는 체크포인트에 eval_f1 = -1.0이 들어 있었다. 값이 비어 있으면 안 될 것 같아서 넣은 것인데, F1 차트에 -1이 찍혀서 그래프 전체가 못 쓰게 됐다.
모르면 비워둔다. 비어 있는 것 자체가 정보다. "이 체크포인트는 성능을 측정한 적이 없다"는 사실이 화면에 그대로 보이는 쪽이 낫다.
epochs = "unknown"처럼 params에는 문자열 자리표시자를 남겼는데, 이것은 metrics와 달리 차트에 올라가지 않고 "당시 기록이 없었다"는 사실을 남기는 쪽에 가깝다. 같은 params 키를 모든 런이 갖게 해두면 비교 표가 깨지지 않는다.
3. stage로 운영 상태를 관리한다
| stage | 뜻 | 해당 버전 |
|---|---|---|
production | 현재 운영 | checkpoint-3064-pv, checkpoint-kor-invoice-r01, rec_korean_v6_korean_boost |
rollback | 문제 시 되돌릴 대상 | checkpoint-2866-pv |
superseded | 다음 버전으로 대체됨 | latin-r01, 9000, 9240-pv, v5, checkpoint-440 |
archived | 동결. 계보에서 갈라진 가지 | 1620, 9240, 740, 공개 데이터셋 계열 |
rollback을 별도 상태로 둔 것이 핵심이다. superseded와 섞어두면 "대체됐다"까지만 알 수 있고, 그중 어느 것으로 되돌려야 하는지는 여전히 모른다. 운영 사고 중에 판단할 일을 미리 적어둔 셈이다.
4. parent_checkpoint로 계보를 잇는다
이어학습으로 모델을 올리면, 체크포인트 하나의 성능은 그 자체로 설명되지 않는다. 무엇을 물려받았는지를 모르면 성능 변화의 원인을 가릴 수 없다.
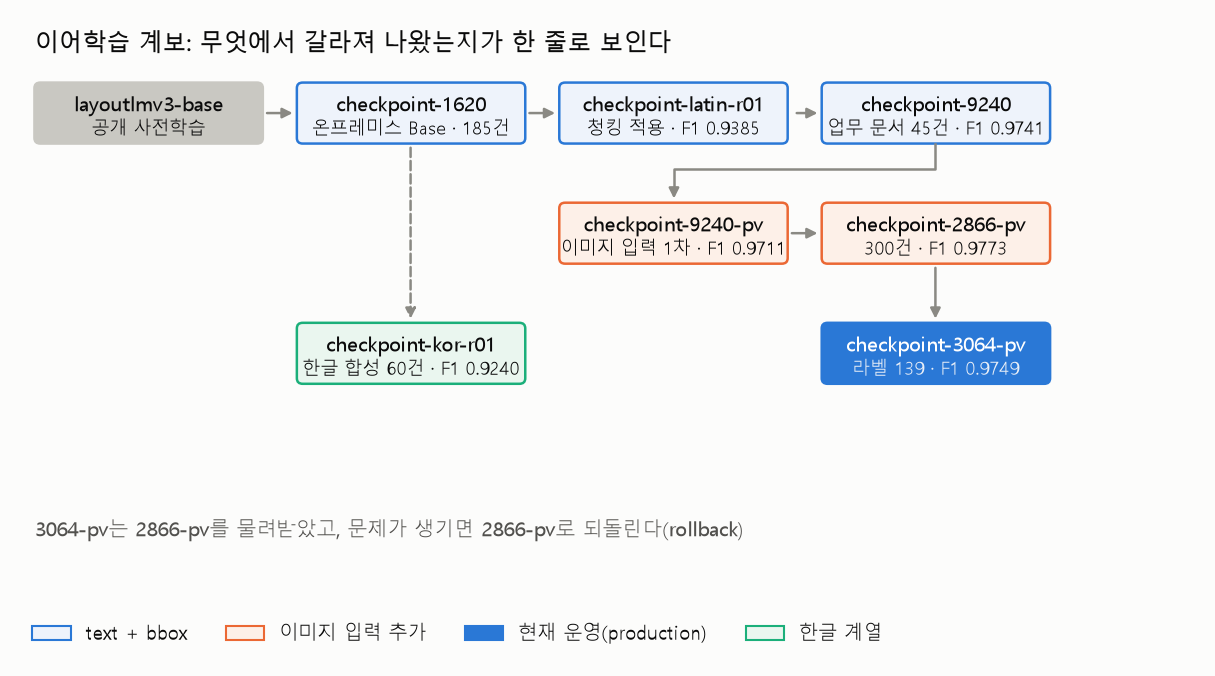
OCR 인식기도 같은 방식이다.
rec_korean_v3_special_char
   └─ v4_decimal_contrast
        └─ v5_mixed_boost
             └─ v6_korean_boost  [production]
계보를 태그로 박아두면 "이 체크포인트가 무엇에서 갈라져 나왔는가"가 한 줄로 보인다. 반복 파인튜닝에서 망각을 막으려고 누적 학습을 택한 것도 이 계보 위에서만 말이 되는 이야기다.
9240-pv에서 학습률을 모달리티별로 나눈 이유
이 계보에서 가장 중요한 결정이 여기다. checkpoint-9240까지는 text와 bbox만 입력으로 썼는데, 표 구조를 못 잡아서 이미지 입력(pixel_values)을 추가하기로 했다. 문제는 그 시점의 가중치 상태가 불균형이었다는 점이다.
text / bbox encoder  → 이미 수렴. task에 최적화됨
image encoder        → 원본 그대로. 학습된 적 없음
같은 학습률을 쓰면 어느 쪽이든 망가진다.
| LR | 결과 |
|---|---|
| 작게 | text/layout은 안정. image encoder가 거의 안 배운다 |
| 크게 | image encoder는 배우지만 text/layout이 기존 지식을 잊는다 |
그래서 모달리티별로 나눴다.
LR_TEXT_LAYOUT   = 1e-5   # 이미 수렴했으므로 조심스럽게
LR_IMAGE_ENCODER = 5e-5   # 미학습이므로 5배 높게
_IMAGE_KEYWORDS = ["patch_embed"]
처음부터 재학습하지 않고 이어학습을 택한 것도 같은 판단이다. 기존 F1 0.9741을 유지한 채로 시작할 수 있고, 새로 필요한 것은 이미지가 포함된 데이터뿐이었다.
input_mode 태그를 둔 것도 이 분기 때문이다. text+bbox 계열과 pixel_values 계열은 추론 코드가 다르다. 섞어 쓰면 학습과 추론의 입력이 어긋난다.
5. eval_set_id가 없으면 숫자를 잘못 읽는다
이 체계에서 가장 중요한 부분이다. F1은 같은 평가셋에서 잰 것끼리만 비교할 수 있다. 실제로 잘못 읽었던 사례가 두 개 있다.
사례 ① 2차에서 3차로 넘어가며 F1이 떨어진 것처럼 보였다
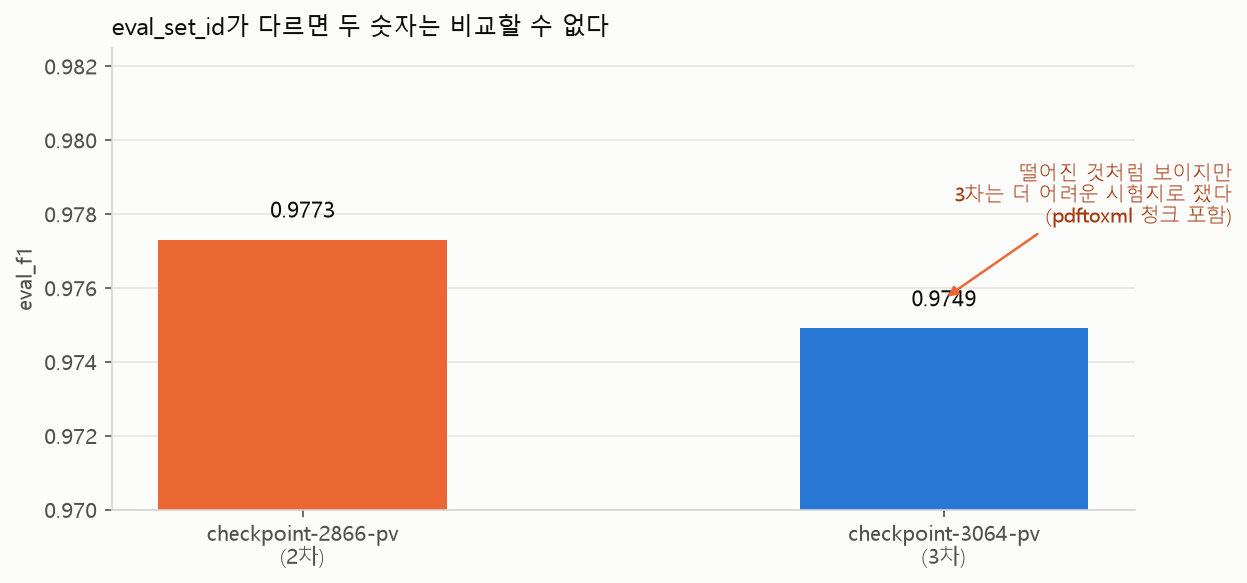
숫자만 보면 퇴보다. 그런데 3차는 test split에 pdftoxml 경로로 뽑은 청크가 들어갔다. 시험지가 다르다. 성능이 나빠진 것이 아니라 더 어려운 시험을 본 것이다.
라벨 수도 이때 139개로 늘었다(I-CNTR_ERD_DATE 추가). 라벨 수가 바뀌면 분류 head 크기가 달라져서 이전 체크포인트와 가중치 호환이 끊긴다. 그래서 num_labels도 모든 런이 갖는 params에 넣었다.
사례 ② OCR 평균 신뢰도가 좋아진 것처럼 보였다
avg_conf v5 0.9710 → v6 0.9787 ← 올라갔다
avg_conf는 그 런에 있는 지표들의 단순 평균인데 분모가 달랐다. v6에서 새로 추가된 4개 지표가 평균 0.9964로 쉬운 항목이었고, 그것들이 평균을 끌어올렸다.
공통 지표만 놓고 보면 방향이 반대다.
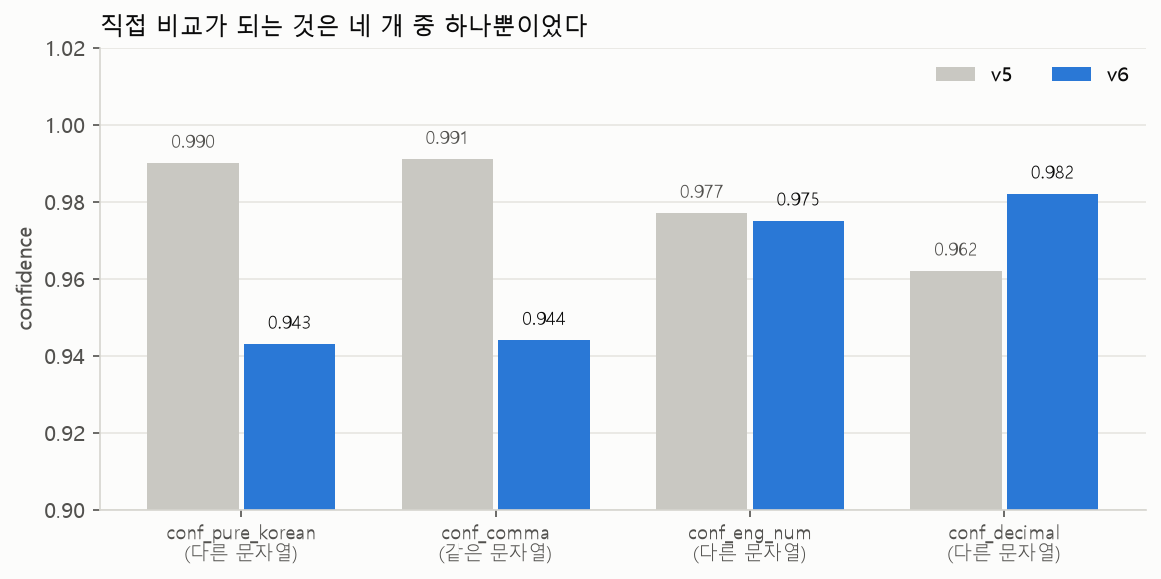
그래서 avg_conf를 기록에서 뺐다. 계산 근거가 런마다 달라지는 지표는 남겨두면 언젠가 잘못 읽힌다.
그런데 여기서 한 겹 더 들어가면, 이 공통 4개조차 서로 다른 테스트 이미지에서 잰 값이었다.
| 지표 | v5 테스트 문자열 | v6 테스트 문자열 | 비교 |
|---|---|---|---|
conf_pure_korean | 제조업 0.990 | 에버그린스타 0.943 | 불가 |
conf_decimal | 7825.10 0.962 | 5886.85 0.982 | 불가 |
conf_eng_num | 0.977 | 0.975 | 불가 |
conf_comma | 16,642,333 0.991 | 16,642,333 0.944 | 가능 |
직접 비교가 되는 것은 conf_comma 하나뿐이고, 0.991에서 0.944로 떨어졌지만 읽은 값은 양쪽 다 16,642,333으로 정확했다. confidence는 "얼마나 확신했나"이지 "맞았나"가 아니다.
즉 "공통 4지표 평균이 0.980에서 0.961로 하락"이라고 적었던 것도 근거가 되지 못한다. 서로 다른 이미지의 confidence를 평균낸 값이기 때문이다. 비교 불가인 런에는 태그로 이유를 적어뒀다.
checkpoint-3064-pv  note="test split에 pdftoxml 청크 포함. 2차와 시험지가 달라 직접 비교 불가"
rec_korean_v6       note="eval_set이 달라 판정 보류"
6. OCR 라운드는 데이터 구성만 독립변수로 뒀다
ocr-rec-kor의 네 런은 학습 설정이 전부 같다.
| 파라미터 | 값 | 이유 |
|---|---|---|
epoch batch_size learning_rate warmup_epoch | 20 · 128 · 0.001 · 2 | v3부터 v6까지 고정. 학습 설정을 같이 바꾸면 무엇이 효과를 냈는지 가릴 수 없다 |
image_shape | [3, 48, 320] | 서버 배포 호환성 문제를 겪고 고정. 바꾸면 추론 엔진 쪽이 깨진다 |
character_dict_size | 3,694 | v3에서 괄호를 추가해 3,692에서 3,694로. 사전이 바뀌면 이전 체크포인트와 호환되지 않는다 |
boost_* 계열 | 라운드별 | 각 라운드의 유일한 변경점 |
korean_boost_composition | 문자열 | 8,000건의 내역(회사명 2,000 + 이름 1,000 + 주소 1,500 등). 총량만으로는 재현이 안 된다 |
overfit_comma_to_decimal | 0 | v3의 과적합을 다시 겪지 않으려고 만든 지표 |
마지막 줄이 이 실험에서 가장 쓸모 있었던 기록이다. v3에서 소수점 데이터를 5,500건 넣었더니 쉼표를 소수점으로 읽는 과적합이 생겼다. 금액 63,616,446이 63,616.446이 되는 식이다. 성능 지표는 올라갔는데 실무에서는 더 나빠진 상태였다.
그래서 v4에서는 소수점 데이터를 4,500건으로 줄이고 쉼표 대조군 1,000건을 같이 넣었다. boost_decimal이 5,500에서 1,500으로 줄어든 것이 그 교훈이다. 데이터를 많이 넣는 것이 답이 아니었고, 대조군을 같이 넣는 것이 답이었다.
overfit_comma_to_decimal은 성능이 아니라 부작용을 재는 지표다. 다른 숫자가 다 올라가도 이것이 1이면 그 라운드는 실패다. 이 과정은 한글 OCR 파인튜닝 6라운드에 자세히 적어뒀다.
7. 영문 모델을 한글에 재활용한 기록
checkpoint-kor-invoice-r01은 한글 전용 base에서 출발하지 않고 영문 계보의 checkpoint-1620을 부모로 삼았다.
한글 데이터가 부족해서가 아니라, 인보이스라는 문서 구조 지식이 언어와 무관하기 때문이다. "여기는 금액 칸, 저기는 날짜 칸"이라는 배치 감각은 영문에서 배운 것이 그대로 쓰인다. LayoutLM이 좌표를 입력으로 받는 모델이라는 점이 여기서 값을 한다.
합성 문서 60건, 30 epoch로 F1 0.9240을 얻었다. epochs=30이 영문 계열(2~10)보다 훨씬 큰 것은 데이터가 60건뿐이라 반복 횟수로 보완한 것이고, params에 남겨두지 않으면 나중에 "왜 이것만 30인가"를 다시 물어야 한다.
8. 평가 런은 하나뿐이다
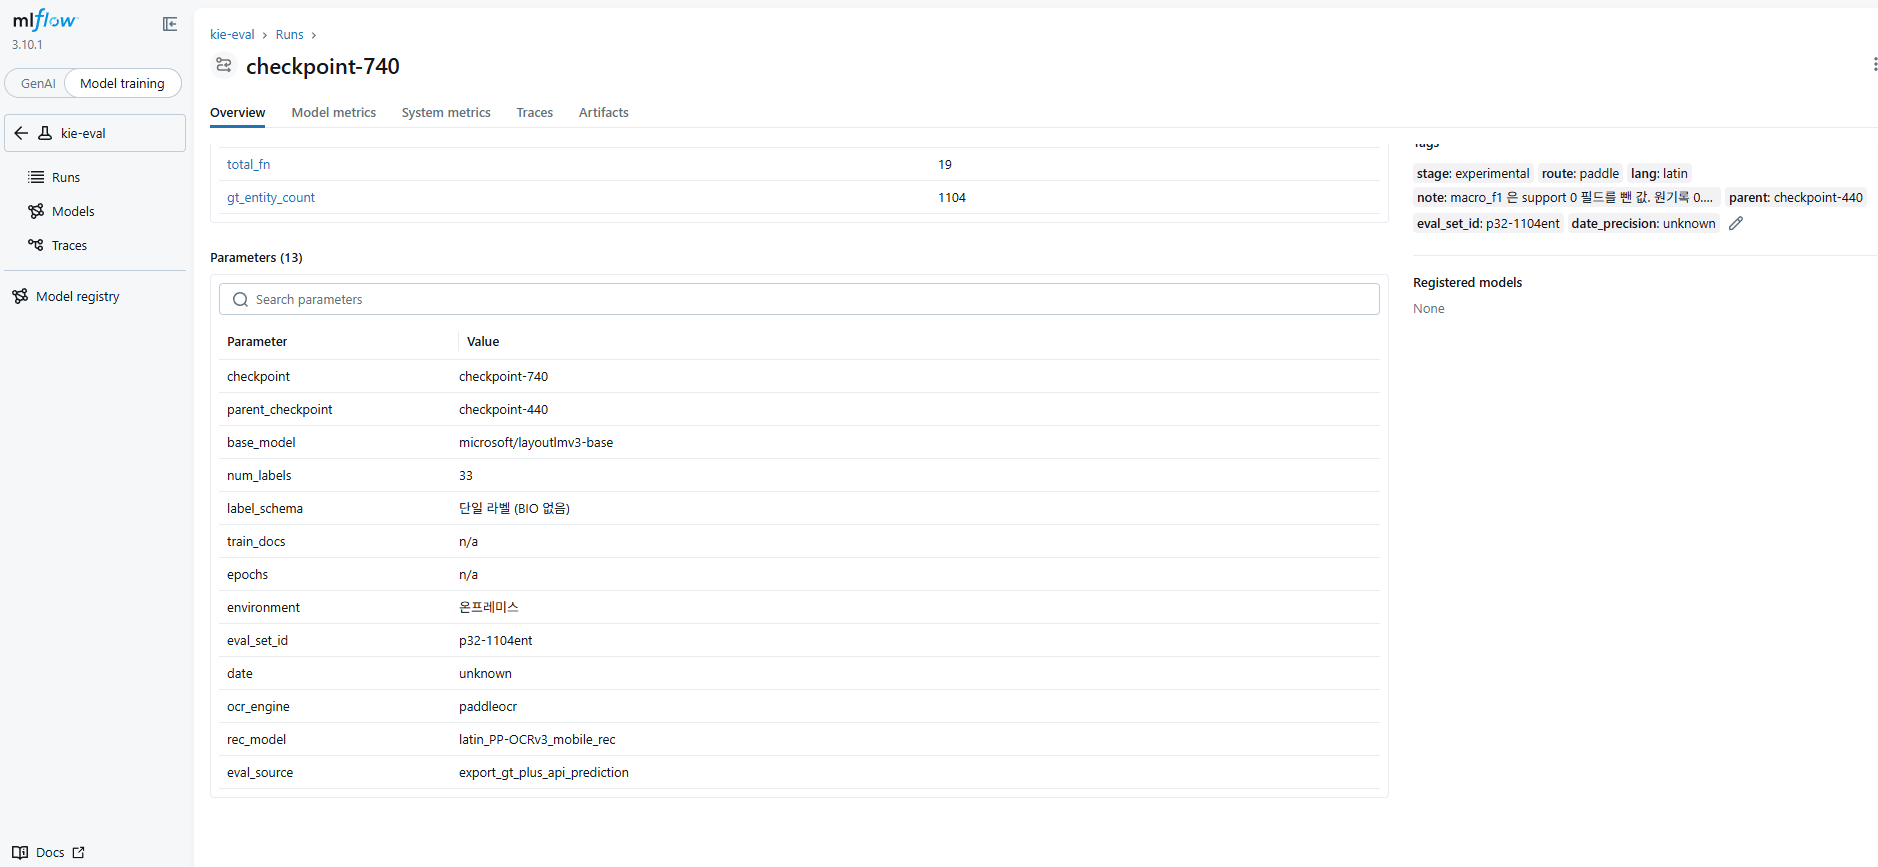
checkpoint-740은 학습 성적 기록이 없고 평가 성적만 있다.
micro_f1  0.9792     실제 문서. OCR 포함
macro_f1  0.9766     support 0인 필드 제외
macro_f1을 macro_f1_nonzero로 이름을 바꿔 기록했다. 원 기록의 0.9417은 정답이 0건인 필드의 F1을 0으로 세어 평균에 넣은 값이라, 모델 성능이 아니라 평가셋 구성을 반영하고 있었다.
9. 현재 운영 버전
| 계열 | 버전 | 성능 | 비고 |
|---|---|---|---|
| 영문 정보추출 | checkpoint-3064-pv | F1 0.9749 | 라벨 139개, pixel_values |
| 한글 정보추출 | checkpoint-kor-invoice-r01 | F1 0.9240 | 합성 60건, ep.30 |
| 한글 OCR 인식 | rec_korean_v6_korean_boost | 지표별 개별 관리 | 학습 53,700건 |
| 롤백 대상 | checkpoint-2866-pv | F1 0.9773 | 2차 결과 보존 |
재기록은 스크립트 두 개로 한다. mlflow_rebuild.py가 중복 런을 정리하고 계보 17건을 규약대로 다시 쓰며 --dry-run을 지원하고, mlflow_inspect.py는 현황만 출력하고 아무것도 바꾸지 않는다. 먼저 dry-run으로 결과를 보고 적용한다.
10. 남은 것
| 항목 | 내용 |
|---|---|
eval_set_id가 대부분 unknown | 각 체크포인트를 어떤 데이터로 쟀는지 당시 기록이 필요하다. 채워지기 전까지 버전 간 F1 비교는 참고값이다 |
| 기존 실험 5개 정리 | 정비 전 실험들이 새 실험과 겹친다 |
| 고정 평가셋 구축 | 위 항목을 근본적으로 푸는 방법 |
| 부작용 지표 확대 | OCR의 overfit_comma_to_decimal 같은 지표를 LayoutLM 쪽에도 |
마지막 줄이 이 정비에서 얻은 가장 옮길 만한 아이디어다. 성능 지표는 좋아진 것만 보여주고, 나빠진 것은 부작용 지표를 따로 만들어야 보인다.
배운 점
이름에 정보를 넣으면 정보가 죽는다. 런 이름에 모델, 체크포인트, 데이터셋, 용도를 다 넣었더니 사람만 읽을 수 있는 문자열이 됐다. 이름은 식별자로 두고 정보는 params와 tags로 빼자 검색과 필터가 살아났다. 로그 설계에서도 같은 이야기를 여러 번 했는데, 실험 관리에서 다시 만났다.
모르는 값은 비워두는 것이 정보다. eval_f1 = -1.0 하나가 차트 전체를 못 쓰게 만들었다. 빈칸을 싫어해서 넣은 값이 빈칸보다 나쁜 결과를 냈다. "측정한 적이 없다"는 사실은 숨길 것이 아니라 드러내야 하는 상태다.
비교 가능성은 지표가 아니라 메타데이터가 결정한다. 0.9773과 0.9749를 놓고 퇴보라고 읽을 뻔했는데, 실제로는 시험지가 바뀐 것이었다. 숫자를 아무리 정확하게 기록해도 eval_set_id가 없으면 그 숫자로 판단을 내릴 수 없다. 지금 eval_set_id가 대부분 unknown이라는 사실이, 이 체계에서 가장 정직하게 봐야 할 부분이다.
도구를 도입하는 것과 체계를 만드는 것은 다른 일이다. 버전 관리 자체는 markdown 문서로 이미 하고 있었다. 이번 작업은 없던 것을 만든 것이 아니라, 사람이 읽어야 알 수 있던 것을 쿼리로 물을 수 있게 옮긴 것이다. MLflow를 붙였다는 사실보다 무엇을 규약으로 정했는가가 실제로 일을 바꿨다.
참고 자료
- MLflow Tracking: experiment, run, params, metrics, tags 개념
- MLflow Model Registry: stage 관리의 표준 형태
- LayoutLMv3 (Microsoft): text, layout, image 세 모달리티 구성
- Howard & Ruder, 2018. ULMFiT: 레이어별 학습률 차등의 근거
- PaddleOCR 인식 모델 학습 문서: 문자 사전과
image_shape제약
이어 읽기
- F1이 세 개였다: 같은 이름으로 다른 것을 재고 있었던 기록: 각 실험의 지표가 실제로 무엇을 재는지
- 반복 파인튜닝과 망각 방지: 누적 학습과 차등 학습률: 계보를 이어가며 기존 성능을 지킨 방법
- 정확도 99.97%인데 쓸 수 없던 모델: 한글 OCR 파인튜닝 6라운드: 데이터 구성만 바꿔가며 라운드를 돈 과정
- 무엇으로 잘한다고 말할 것인가: 평가 지표와 고정 벤치마크:
eval_set_id를 채우려면 결국 필요한 것 - Document AI 성능 측정 체계 구축: OCR부터 MLflow까지: 측정 체계 전체 구조