들어가며
잘 학습된 베이스 모델에 새로운 문서 양식을 20~60건만 추가로 학습시켰는데 성능이 크게 올라가는 일을 여러 번 겪었다. 어떤 경우는 학습 전 F1 0.44에서 20건 학습 후 0.97까지 올랐다.
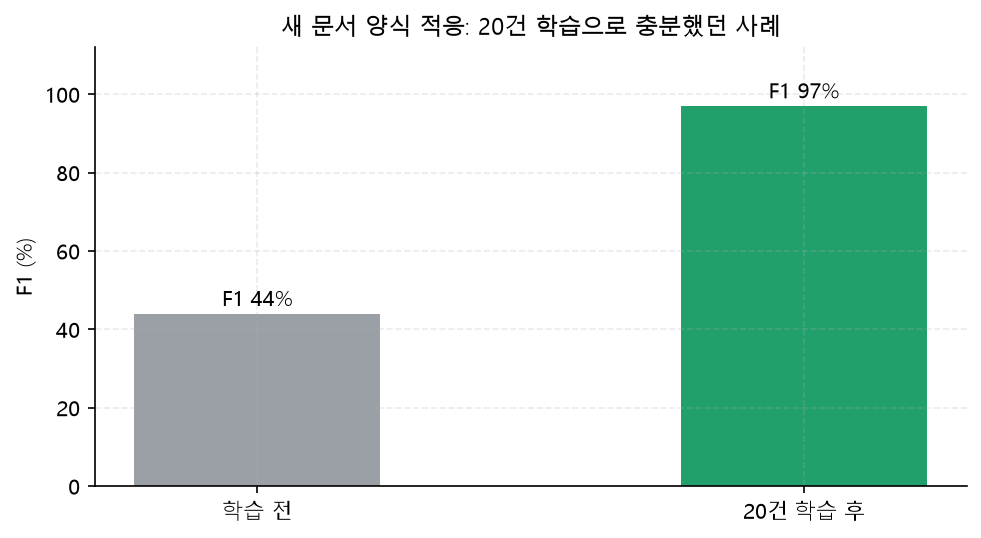
이게 가능한 이유는 단순하다. 모델이 "필드가 어떻게 생겼는지 인식하는 능력"은 이미 다른 도메인에서 배운 상태이고, 새 양식은 같은 개념이 조금 다른 위치와 모양으로 나타난 것이기 때문이다. 완전히 새로운 걸 배우는 게 아니라 아는 것을 어디에 적용할지만 재조정하면 되니 데이터가 적게 든다.
그런데 이 관찰은 곧 다음 문제로 이어졌다.
문제: 도메인마다 모델을 통째로 복제한다
소량 적응이 잘 통한다는 걸 알면 자연스럽게 "도메인마다, 고객마다 따로 적응시킨 모델을 두자"는 결론에 이른다. 문제는 지금까지의 방식이 전부 모델 전체 가중치를 학습하고 저장하는 구조라는 점이다.
도메인 A → checkpoint-A (480MB)
도메인 B → checkpoint-B (480MB)
고객 C  → checkpoint-C (480MB)
...
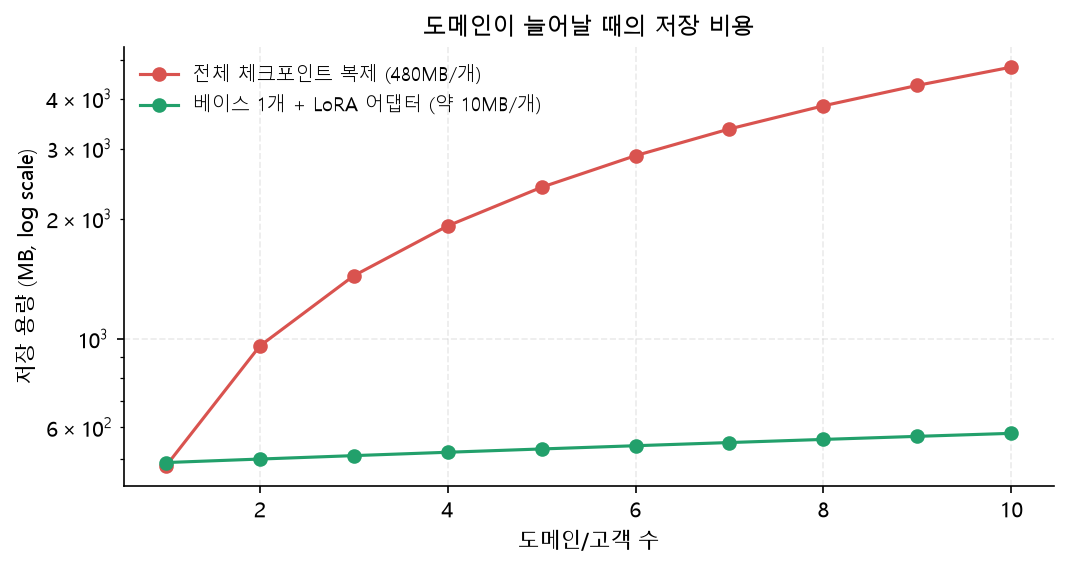
분기가 몇 개일 때는 감당할 만하지만, 늘어날수록 저장 비용과 "이 고객에게 어느 체크포인트를 배포할지" 관리 부담이 함께 커진다.
LoRA: 원본은 얼리고 보정만 학습한다
LoRA(Low-Rank Adaptation)는 원본 가중치를 동결하고 작은 보정 행렬만 학습하는 방법이다.
기존 방식:  W 자체를 고쳐 쓴다
           W → W′        (768×768 행렬 하나 = 약 59만 개 숫자)

LoRA:      W는 동결하고 옆에 작은 보정 행렬만 학습한다
           W′ = W + B×A
                  ↑ B는 (768×r), A는 (r×768)
                    r=8이면 학습 대상은 원본의 약 2%
원본 규칙집은 잠가두고 페이지마다 포스트잇을 붙이는 셈이다. 고객·도메인별로 필요한 저장 공간이 480MB에서 수 MB 수준의 어댑터로 줄어든다.
LoraConfig(
    task_type=TaskType.TOKEN_CLS,
    target_modules=["query", "value"],   # 보정을 붙일 가중치 행렬
    r=8,                                  # 보정 행렬의 rank
    lora_alpha=16,
    lora_dropout=0.1,
    modules_to_save=["classifier"],       # 분류 헤드는 통째로 학습
)
LoRA가 건드리지 않는 것: 좌표 임베딩
설정을 다시 보면 학습되는 건 어텐션 Q·V 어댑터와 분류 헤드뿐이다. 나머지는 전부 얼어 있고, 그 "나머지"에 좌표 임베딩이 들어간다. 이게 문서 AI에서는 생각보다 중요한 지점이다.
LayoutLMv3는 단어의 bbox를 0~1000으로 정규화한 뒤, 좌표별 임베딩 테이블에서 벡터를 꺼내 텍스트 임베딩에 더한다. x, y, 너비, 높이가 각각 테이블을 가진다.
단어 "TOTAL" + bbox(820, 140, 60, 20)
        ↓
텍스트 임베딩 + x=820 벡터 + y=140 벡터 + w/h 벡터
        ↓
트랜스포머 어텐션        ← LoRA는 여기에만 붙는다
        ↓
라벨 분류
풀 파인튜닝은 이 테이블까지 조정한다. 이 도메인에서 좌표가 무엇을 의미하는지를 모델이 다시 배우는 셈이다. 반면 LoRA는 테이블을 그대로 두고, 고정된 좌표 벡터를 어텐션이 어떻게 해석할지만 바꾼다. 덧붙이면 LayoutLM 계열은 어텐션 안에 2D 상대 위치 bias 같은 테이블형 파라미터도 쓰는데, LoRA는 선형 계층을 감싸는 방식이라 이런 파라미터도 대상이 아니다.
잘 될 수도, 막힐 수도 있다
새 양식에 적응한다는 건 대부분 같은 필드가 다른 위치에 나타나는 것을 배우는 일이다. 그 적응이 어디에서 일어나느냐에 따라 결과가 갈린다.
| 가설 | 근거 |
|---|---|
| 잘 된다 | 좌표 임베딩은 "이 위치는 이런 벡터"라는 범용 사전에 가깝다. 바뀌어야 하는 건 "이 헤더 오른쪽에 있으면 금액"이라는 관계 판단이고, 그건 어텐션에서 일어난다 |
| 막힌다 | 그동안의 풀 파인튜닝에서 좌표 테이블이 이미 이 도메인에 특화됐을 수 있다. 그렇다면 테이블을 얼리는 순간 레이아웃이 크게 다른 문서에서 적응 폭이 제한된다 |
하필 서비스에서 어려운 문서가 두 번째 경우에 해당한다. 표 테두리가 없는 문서, 리스트가 길게 이어지는 문서, 한 행에 값이 묶여 나오는 문서다.
어느 쪽인지는 모델 내부를 들여다봐서 알 수 있는 게 아니라 같은 조건으로 돌려봐야 알 수 있다. 그래서 테스트를 풀 파인튜닝(기준선), r=8, r=16 세 갈래로 설계했다. 데이터와 seed, epoch을 모두 고정해야 비교가 성립한다.
측정한다면 평균 F1이 아니라 이걸 본다
| 볼 것 | 이유 |
|---|---|
| 표 행 단위 필드의 F1 | 행 경계는 좌표 의존도가 가장 높다 |
| 표 테두리 없는 문서만 따로 집계 | 시각·좌표 단서가 약한 케이스 |
| 레이아웃이 크게 다른 신규 양식 | 적응 폭의 한계가 드러나는 지점 |
여기서 LoRA가 밀린다면 선택지는 있다. modules_to_save에 좌표 임베딩을 추가해 그 테이블만 풀 학습하거나, target_modules를 key와 FFN까지 넓히거나, r을 키우는 방식이다. 다만 그럴수록 어댑터가 커져서 "수 MB로 줄인다"는 도입 명분 자체가 약해진다.
빠뜨리면 틀린 결론이 나오는 두 가지
절차서를 쓰면서 가장 신경 쓴 부분이다. 둘 다 "LoRA는 성능이 안 나온다"는 잘못된 결론으로 이어진다.
modules_to_save=["classifier"]를 빠뜨리면 분류 헤드가 동결돼 라벨을 아예 배우지 못한다. 라벨이 139~148개로 계속 늘어난 서비스라 더 치명적이다.- 학습률을 기존 1e-5로 두면 학습이 거의 진행되지 않는다. 1e-5는 이미 학습된 가중치를 미세 조정하는 값이고, LoRA는 0에서 시작하는 작은 행렬을 배우는 것이라 2e-4 수준이 필요하다. 기존 차등 학습률 설정(텍스트 1e-5 / 이미지 5e-5)도 그대로 쓰면 안 된다. LoRA 적용 후에는 파라미터 이름이 바뀌어 그룹 분리 자체가 의도대로 걸리지 않는다.
적용 절차까지 만들었지만
테스트 절차를 문서로 정리했다. 어떤 모듈에 어댑터를 붙일지, 어떤 데이터로 검증할지, 기존 전체 파인튜닝과 어떤 지표로 비교할지까지요.
그런데 적용은 보류했다. 이유는 성능이 아니라 운영 구조였다.
| 항목 | 전체 체크포인트 방식 | LoRA 방식 |
|---|---|---|
| 저장 비용 | 도메인 수에 비례 | 베이스 1개 + 작은 어댑터 |
| 추론 서버 | 체크포인트 경로만 바꾸면 됨 | 베이스 + 어댑터 로딩 경로가 추가됨 |
| 롤백 | 이전 체크포인트로 교체 | 어댑터와 베이스 버전 조합을 함께 관리 |
| 검증 | 기존 절차 그대로 | 어댑터 조합별로 검증 필요 |
현재 도메인 분기 수에서는 저장 비용 절감보다 운영 경로가 둘로 나뉘는 비용이 더 컸다. 모델을 서비스에 붙이는 일에서 경로가 하나 늘어난다는 건, 장애 상황에서 확인할 곳이 하나 늘어난다는 뜻이기도 한다.
언제 도입할 것인가
보류는 "하지 않는다"가 아니라 "지금은 아니다"이다. 도입 기준을 이렇게 적어뒀다.
- 도메인·고객별 분기가 두 자릿수로 늘어날 때
- 같은 베이스에서 갈라진 체크포인트의 저장·배포 관리가 실제 부담이 될 때
- 고객사마다 모델을 격리해야 하는 요건이 생길 때
셋 중 하나라도 해당되면 그때는 어댑터 방식이 더 단순해진다.
배운 점
좋은 기술이라고 지금 필요한 건 아니었다. LoRA는 논문도 많고 사례도 많다. 저장 비용 그래프만 보면 안 쓸 이유가 없어 보인다. 그런데 우리 상황에서 실제로 아끼는 건 수백 MB였고, 대신 늘어나는 건 추론 경로 하나였다. 숫자가 큰 쪽이 아니라 운영이 단순한 쪽을 골랐다.
검토한 내용을 기록으로 남긴 게 도움이 됐다. 보류하면 검토 자체가 사라지기 쉬운데, 절차와 판단 근거를 문서로 남겨두니 나중에 조건이 바뀌었을 때 처음부터 다시 조사하지 않아도 된다. 도입 기준과 함께, 무엇이 아직 검증되지 않았는지(좌표 임베딩이 얼어 있을 때 레이아웃 적응이 어디까지 되는지)도 같이 적어뒀다. 다시 꺼낼 때 그 지점부터 확인하면 된다.
소량 적응이 잘 통한다는 관찰 자체가 더 큰 자산이었다. 20건으로 새 양식에 대응할 수 있다는 걸 알고 나니, 새 고객 문서가 들어와도 "며칠이면 붙는다"고 답할 수 있게 됐다. 기술 선택보다 이 감각이 서비스 설계에 더 많이 쓰였다.
도입 판단의 기준은 기술이 아니라 운영이었다. 성능이 좋아지는가만 물었다면 결론이 달랐을 것이다. 실제로 물은 건 하나였다. 이걸 쓰면 관리할 것이 늘어나는가, 줄어드는가.
이어 읽기
- 반복 파인튜닝과 망각 방지: 누적 학습과 차등 학습률: LoRA 대신 선택한 학습 방식
- 무엇으로 잘한다고 말할 것인가: 평가 지표와 고정 벤치마크: 적용 여부를 판단할 때 쓸 측정 기준
- AI 사전상담 에이전트를 설계하고, 직접 만들지 않기로 한 이유: 비교 범위가 도입 판단을 바꾼 또 다른 사례