들어가며
LayoutLMv3는 한 번에 512토큰까지만 본다. 문서가 길면 뒤쪽은 그냥 잘린다.
처음에는 이 사실을 대수롭지 않게 넘겼다. truncation=True를 켜두면 에러 없이 동작하기 때문이다. 문제는 잘린 부분이 학습되지 않는다는 것이었다. 에러도 경고도 없이, 모델이 문서의 아랫부분을 한 번도 보지 못한 채 운영되고 있었다.
문서 구조:
  [상단] 요금 테이블          → 학습됨
  [중간] Notes / 주소 / 날짜   → 학습됨
  [하단] 품목 세부 내역        → 잘림 ❌

→ 하단 필드는 모델이 한 번도 본 적 없는 상태로 운영 중
언어에 따라 심각도가 다르다
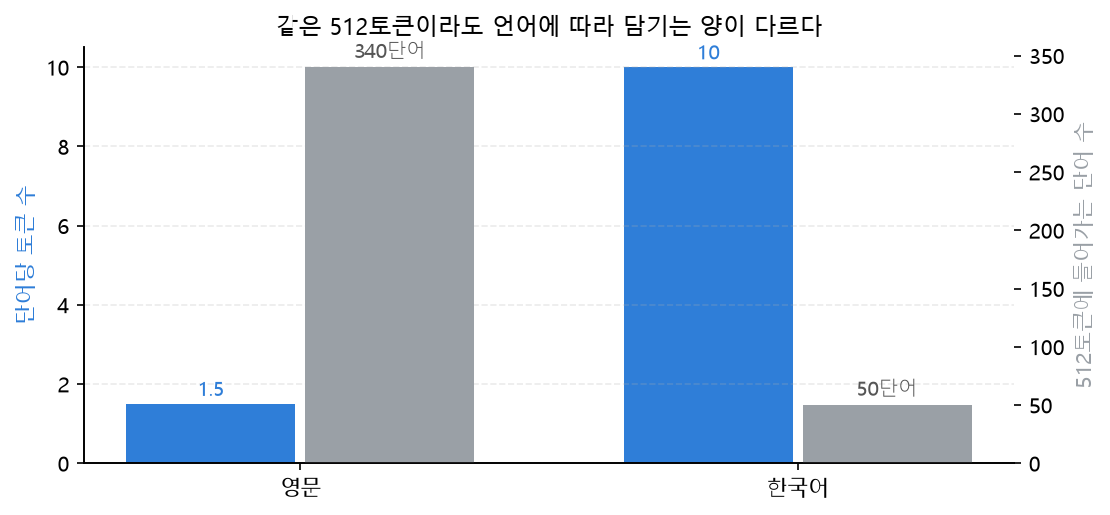
같은 512토큰이라도 언어마다 담기는 단어 수가 다르다.
| 항목 | 한국어 | 영문 |
|---|---|---|
| 단어당 토큰 수 | 약 6~15개 (평균 10) | 약 1.5개 |
| 512토큰에 들어가는 단어 | 약 50단어 | 약 340단어 |
| 잘림 심각도 | 매우 높음 | 긴 문서에서 발생 |
한국어는 50단어만 넘어가도 잘린다. 영문은 340단어까지 버티지만, 품목이 길게 나열되는 인보이스는 그 선을 넘는다. 한국어에서 먼저 발견한 문제가 영문 스크립트에도 그대로 있었던 셈이다.
청킹: 문서를 나눠서 넣기
해법은 문서를 여러 조각으로 나눠 각각 추론하고 결과를 합치는 것이다. 이때 두 가지를 정해야 한다.
| 파라미터 | 값 | 이유 |
|---|---|---|
CHUNK_TOKEN_CAP | 100 (영문) | 단어 하나가 차지할 토큰 수의 상한. 한국어 기준 50에서 영문에 맞게 올림 |
CHUNK_OVERLAP_WORDS | 3 | 청크 경계에서 문맥이 끊기지 않도록 앞 청크의 마지막 단어를 겹쳐서 시작 |
overlap이 중요한 이유는 경계에 걸친 필드 때문이다. 청크를 딱 잘라 붙이면 "INVOICE"와 "NO"가 서로 다른 청크로 나뉘어, 모델이 둘을 한 필드로 보지 못한다. 앞 청크의 끝 단어 몇 개를 다음 청크가 다시 가져가면 이 문제가 줄어든다.
그렇다고 겹침을 크게 잡을 수도 없다. 겹치는 만큼 같은 단어가 여러 청크에 등장하고, 그러면 한 단어에 예측이 두 개 생긴다. 어느 쪽을 채택할지 정하는 규칙이 필요해지고, 추론량도 함께 늘어난다. overlap 3은 경계 필드를 살리면서 중복을 최소로 두는 선에서 정한 값이다.
두 파라미터의 성격도 다르다. CHUNK_TOKEN_CAP은 언어에 따라 바뀌는 값(한국어 50, 영문 100)이고, overlap은 필드가 몇 단어로 이뤄지는지에 달린 값이라 언어와 무관하다. 설정을 옮길 때 무엇을 같이 바꿔야 하고 무엇은 그대로 둬도 되는지가 여기서 갈린다.
그런데 청크가 193개까지 생겼다
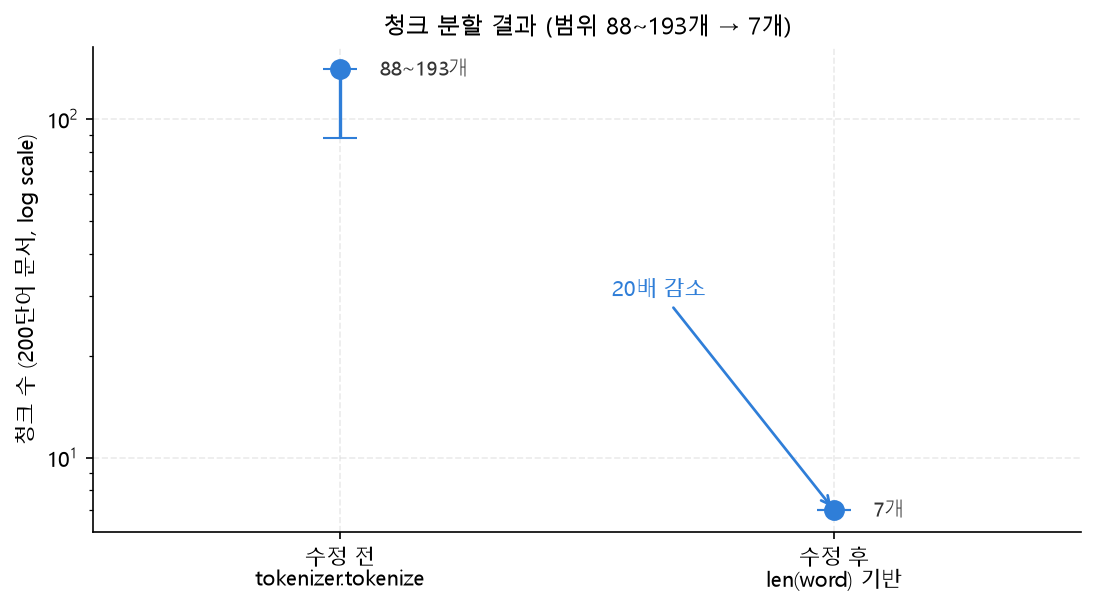
청킹을 적용하자 이번엔 속도가 문제였다. 200단어짜리 문서 하나가 청크 88~193개로 쪼개졌다. 추론에 건당 25.6초가 걸렸다.
원인은 청크 크기를 계산하는 코드 한 줄이었다.
# 문제 코드
word_tokens = tokenizer.tokenize(word)          # boxes 없이 호출
n = min(len(word_tokens) if word_tokens else 1, token_cap)
LayoutLM 계열 토크나이저는 boxes 인자 없이 tokenize()를 호출하면 단어 내용과 무관하게 항상 512를 반환한다.
text='2'        chars=1  → tokens=512   ← 비정상
text='TOTAL'    chars=5  → tokens=512   ← 비정상
text='Cliente'  chars=7  → tokens=512   ← 비정상
즉 모든 단어가 512토큰짜리로 계산됐고, token_cap=100에 걸려 단어 하나당 100토큰으로 고정됐다. 청크 한도가 510이니 청크 하나에 단어 5개밖에 들어가지 않았던 것이다.
# 수정: 문자 수를 토큰 수의 보수적 추정값으로 사용
n = min(len(word) if word else 1, token_cap)
영어와 스페인어 기준 1문자는 대략 1~2토큰이므로, len(word)는 안전한 상한값이다.
결과
| 항목 | 수정 전 | 수정 후 |
|---|---|---|
| 청크 수 (200단어 문서) | 88~193개 | 7개 |
| 청크당 단어 수 | 4~5개 | 19~53개 |
| LayoutLM 추론 시간 | 약 10초/건 | 2.7초/건 |
| 전체 처리 시간 | 25.6초/건 | 20초/건 |
| 단어 커버리지 | 약 68% | 100% |
| 단어 누락(truncation) | 있음 | 없음 |
여기서 눈여겨본 건 전체 시간이 기대만큼 줄지 않았다는 점이다.
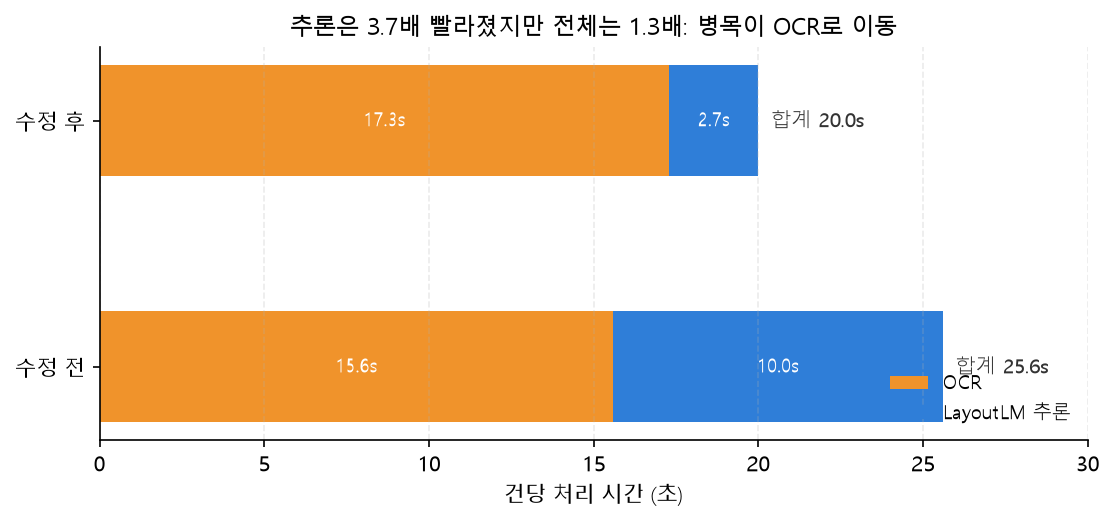
추론 자체는 3.7배 빨라졌는데 전체는 1.3배 단축에 그쳤다. 남은 16초가 OCR 몫이기 때문이다. 이 시점부터 병목은 LayoutLM이 아니라 OCR로 넘어갔고, 추가 속도 개선이 필요하면 손댈 곳도 바뀌었다.
학습과 추론의 청킹이 같아야 한다
한 가지 더 남은 문제가 있었다. 학습 스크립트는 토크나이저 기반으로 청크를 나누는데, 추론 스크립트는 단순히 단어 수(170단어)로 나누고 있었다.
| 항목 | 학습 | 추론(당시) |
|---|---|---|
| 청킹 방식 | 토크나이저 기반 | 단어 수 기반 |
| overlap | 3 | 0 |
| token_cap | 100 | 없음 |
이러면 모델이 학습할 때 본 입력 형태와 추론할 때 받는 입력 형태가 달라진다. 같은 문서인데 조각나는 위치가 달라지니, 학습한 패턴이 그대로 먹히지 않는다.
추론 쪽도 같은 방식으로 맞췄다. 청크 계산과 실제 토크나이저 입력에 동일한 단어 길이 제한을 적용하는 것까지 포함해서다. 청크는 30자 기준으로 세면서 토크나이저에는 원본 단어를 넘기면, 계산과 실제가 어긋나 다시 잘림이 생긴다.
배운 점
에러가 없는 코드가 맞는 코드는 아니었다. tokenizer.tokenize(word)는 예외를 던지지 않고 512를 돌려줬다. 덕분에 파이프라인은 멀쩡히 돌았고, 다만 느렸다. 느린 원인을 찾으려고 청크 수를 찍어보기 전까지는 이상한 점을 눈치채지 못했다. 중간값을 로그로 남기는 습관이 없었다면 더 오래 걸렸을 것이다.
속도 개선은 병목이 어디로 옮겨가는지까지 봐야 끝난다. 추론을 3.7배 줄이고 기뻤지만, 사용자가 체감하는 전체 시간은 1.3배만 줄었다. 단계별로 시간을 쪼개 보지 않았다면 "10배 빨라졌다"고 잘못 보고했을 것이다.
학습과 추론의 입력 조건을 맞추는 일은 원칙으로 세워야 한다. 이 건 이후로 청킹 파라미터는 학습과 추론이 같은 값을 쓰도록 고정하고, 인수인계 문서에도 "어기면 에러 없이 조용히 성능만 떨어진다"고 적어 두었다.
성능 문제의 원인이 모델 밖에 있는 경우가 많았다. 추론이 느렸던 이유는 모델이 무거워서가 아니라 입력을 너무 잘게 쪼갰기 때문이었다. 지표를 의심하고 전제를 다시 본다는 점에서 ECS Fargate StorageWriteBytes 폭증 원인 분석과 비슷한 종류의 조사였다. 느리다는 현상 앞에서 먼저 물어야 할 건 무엇을 몇 번 하고 있는가다.
이어 읽기
- 반복 파인튜닝과 망각 방지: 누적 학습과 차등 학습률: 같은 모델을 학습 쪽에서 다룬 기록
- 양식, 언어, 입력 형태로 나눠 테스트한 이유: 청킹 설정이 양식별로 다르게 작용하는 이유