들어가며
OCR 단계는 영문 문서에서는 기본 모델로 충분했다. 파인튜닝 없이도 숫자와 기호를 잘 읽었기 때문에, 한국어도 비슷할 거라고 생각했다.
그런데 한글 문서에서는 글자는 잘 읽히는데 숫자 주변이 계속 틀렸다.
정답: 7306.40      →  출력: 7306%0
정답: 12,500.00 KG →  출력: 12 500.00 &
금액과 단위가 틀리면 그 뒤의 필드 분류가 아무리 정확해도 결과는 쓸 수 없다. OCR과 NER을 나눈 구조에서 앞 단계의 오류는 뒤로 그대로 전파되기 때문이다.
이 문제를 잡기 위해 Recognition 모델을 여섯 번 파인튜닝했고, 그 과정에서 정확도가 더 높은데도 폐기해야 하는 버전을 두 번 만났다.
여섯 번의 라운드
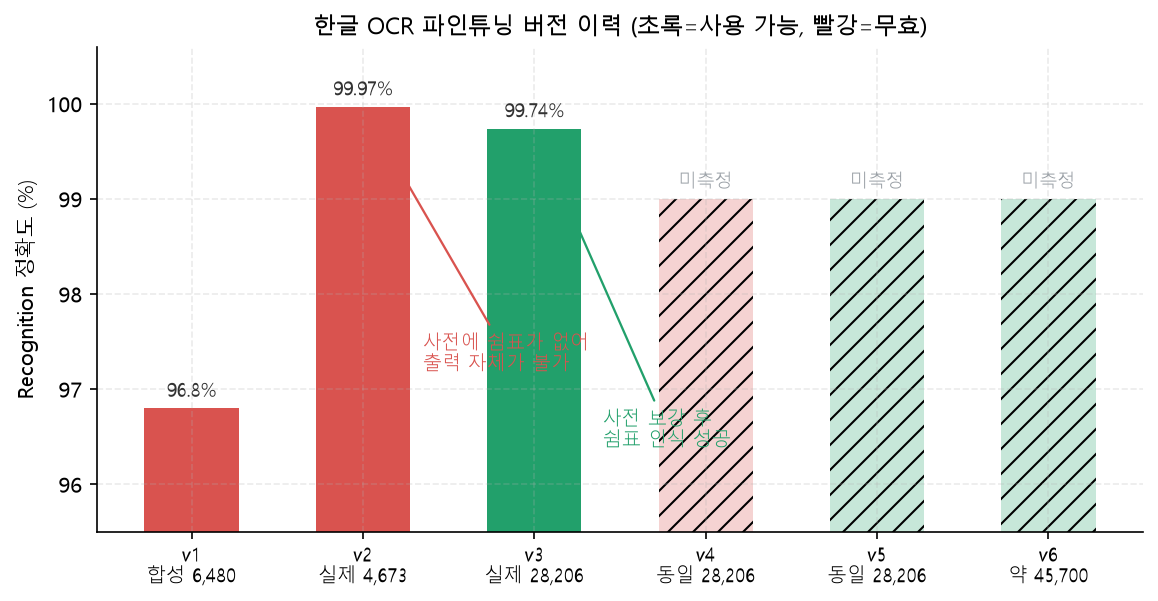
| 버전 | 학습 데이터 | 설정 | 결과 | 사용 여부 |
|---|---|---|---|---|
| 베이스 | - | - | 한글은 인식, 쉼표·소수점 실패 | - |
| v1 | 합성 crop 6,480건 | ep.100 | acc 96.8% | ❌ 무효 |
| v2 | 실제 crop 4,673건 | ep.50, 161분 | acc 99.97% | ❌ 무효 |
| v3 | 실제 crop 28,206건 | ep.20, 64분 | acc 99.74% | ✅ |
| v4 | 동일 28,206건 | ep.20, 약 80분 | 쉼표 미인식 | ❌ |
| v5 | 동일 28,206건 | ep.50, 135분 | 쉼표 인식 성공 | ✅ |
| v6 | 약 45,700건 | ep.20, 약 100분 | 한글 인식 강화 | ✅ 배포 |
정확도만 보면 v2(99.97%)가 가장 좋다. 그런데 v2는 쓸 수 없었다.
v1: 학습이 돌지 않았다
첫 라운드는 합성 데이터로 시작했다. 정답 텍스트를 이미지로 렌더링해 crop을 만드는 방식이다.
결과는 acc 96.8%였지만, 로그를 보니 학습 자체가 진행되지 않았다. 라벨 파일의 줄 끝에 \r이 남아 있어 경로 매칭이 전부 실패했고, 모델은 사실상 베이스 그대로였다. 측정된 96.8%는 베이스 모델의 점수였던 셈이다.
학습 스크립트가 에러 없이 끝났다고 해서 학습이 된 것은 아니다. loss 곡선이 움직였는지부터 확인해야 한다.
v2: 사전에 쉼표가 없었다
두 번째는 실제 문서에서 잘라낸 crop 4,673건으로 학습했다. acc 99.97%. 숫자만 보면 끝난 것처럼 보였다.
그런데 실제 출력에는 여전히 쉼표가 없었다. 원인은 학습이 아니라 문자 사전이었다.
korean_dict.txt  ← 모델이 출력할 수 있는 문자 목록
  가
  나
  ...
  (쉼표 없음)
PaddleOCR의 Recognition은 이 사전에 있는 문자만 출력할 수 있다. 사전에 ,가 없으면 모델이 아무리 학습해도 쉼표를 출력할 방법이 없다. 그리고 평가 데이터에도 쉼표가 없으니, 정확도는 오히려 깨끗하게 99.97%가 나왔다.
측정값이 높았던 이유가 곧 문제의 원인이었다.
사전에 , ₩ .를 추가하고 다시 학습한 것이 v3이다. 데이터도 28,206건으로 늘렸고, 쉼표 인식에 성공했다.
v4~v5: 학습 환경과 배포 환경이 달랐다
v3은 image_shape=[3,48,320]으로 학습했다. 그런데 서버에서 로딩하자 에러가 났다.
학습(SageMaker, PaddlePaddle 3.0):  image_shape = [3, 48, 320]
배포(서버, PaddleX):                image_shape = [3, 32, 320]  ← 강제 적용
→ ReshapeOp 에러
배포 환경이 입력 크기를 32px로 강제하는데, 모델은 48px로 학습된 상태였다. 급한 대로 PaddleX를 우회해 Paddle Inference를 직접 호출하는 방식으로 v3을 띄웠지만, 임시방편이었다.
그래서 32px로 다시 학습한 것이 v4이다. 이번엔 쉼표를 인식하지 못했다. 입력 해상도가 줄면 같은 글자가 더 작게 들어오니, 쉼표처럼 작은 기호는 학습이 더 어렵다. epoch 20으로는 부족했던 것이다.
epoch를 50으로 올린 v5에서 32px + 쉼표 인식을 모두 만족했다.
v6: 데이터를 열 배로
마지막 라운드는 폰트와 크기를 다양화해 약 45,700건으로 학습했다. 현재 배포 버전이다.
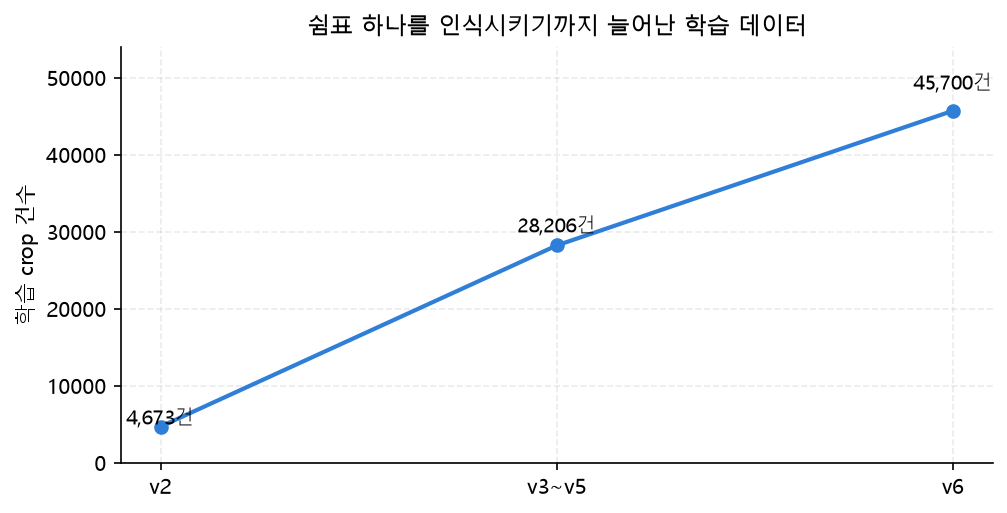
4,673건에서 45,700건까지 열 배 가까이 늘어났는데, 이건 처음부터 계획한 규모가 아니었다. 라운드를 돌면서 무엇이 부족한지 하나씩 알게 된 결과이다.
라운드마다 추가된 확인 절차
무효가 된 두 라운드는 시간을 버렸지만, 대신 학습 전후에 무엇을 확인해야 하는지를 알려줬다. 지금은 새 모델을 학습할 때 이 순서로 확인한다.
학습 전
- 배포 환경이 요구하는 입력 규격(해상도, 채널)이 무엇인가
- 모델이 출력해야 하는 문자가 사전에 전부 들어 있는가
- 평가 데이터에 문제의 문자가 실제로 포함되어 있는가
학습 중
- loss가 움직이는가. 에러 없이 끝났다는 건 학습이 됐다는 뜻이 아니다
- 데이터 경로 매칭이 전부 성공했는가
학습 후
- 정확도 수치와 함께 실제 출력 샘플을 열어본다
- 문제가 됐던 케이스(쉼표, 소수점, 단위)를 따로 모아 본다
세 번째 묶음이 가장 중요하다. 이 목록의 절반은 숫자가 아니라 눈으로 확인하는 항목이다. v2의 99.97%는 샘플 몇 개만 열어봤어도 바로 드러났을 문제였다.
정리
| 라운드 | 배운 것 |
|---|---|
| v1 | 학습이 실제로 돌았는지부터 확인한다 |
| v2 | 모델이 출력할 수 있는 문자 집합(사전)을 먼저 본다 |
| v3 | 데이터를 늘리는 것보다 출력 가능 범위를 여는 게 먼저다 |
| v4 | 배포 환경의 입력 규격을 학습 전에 맞춘다 |
| v5 | 해상도를 줄이면 작은 기호는 더 많은 epoch가 필요하다 |
| v6 | 폰트·크기 다양성이 실문서 대응력을 만든다 |
배운 점
정확도 숫자를 믿지 않게 됐다. v2의 99.97%는 거짓이 아니었다. 다만 그 시험지에 쉼표가 없었을 뿐이다. 지표는 "무엇을 측정했는가"와 함께 읽어야 한다는 걸 이때 배웠다. 이후로는 수치를 받으면 실제 출력 샘플을 먼저 열어본다.
문제가 학습 밖에 있을 수 있다는 것도 배웠다. 쉼표를 못 읽는 문제를 계속 "학습이 부족하다"로 생각했는데, 실제 원인은 사전 파일 한 줄이었다. 데이터를 더 넣는 건 언제나 그럴듯한 해법처럼 보이지만, 그 전에 구조적으로 불가능한 조건이 있는지 봐야 했다.
학습 환경과 배포 환경을 맞추는 일은 미룰수록 비싸진다. v3을 우회 방식으로 띄운 뒤 v4, v5로 두 라운드를 더 쓴 것은, 배포 환경의 입력 규격을 학습 전에 확인했다면 없었을 비용이다. 지금은 새 모델을 학습하기 전에 배포 쪽 제약부터 확인한다.
모델을 바꿀 때마다 판단 기준이 있었던 게 컸다. 정확도 99.97%를 보고도 쓰지 않을 수 있었던 건, 무엇을 기준으로 합격을 판정할지 미리 정해뒀기 때문이다. 그 기준을 세운 과정은 Document AI 성능 측정 체계 구축에, 고정 데이터로 라운드를 비교한 방식은 평가 지표와 고정 벤치마크에 정리했다.
이어 읽기
- PaddleOCR 도입기: Tesseract에서 PaddleOCR로의 전환: 이 파인튜닝의 출발점
- 무엇으로 잘한다고 말할 것인가: 평가 지표와 고정 벤치마크: 라운드 간 비교를 가능하게 한 기준
- OCR과 NER을 왜 나눴나: 문서 AI 파이프라인 모델 선정: OCR만 따로 고칠 수 있었던 이유
- 실험을 네 개로 나눈 이유: MLflow로 모델 계보와 비교 가능성을 관리한 기록: 라운드별 데이터 구성을 params로 남긴 기록
- F1이 세 개였다: 같은 이름으로 다른 것을 재고 있었던 기록: conf_* 가 정확도가 아니라 자기 확신인 이유