프로젝트 개요
운영 인프라 전반에 걸친 통합 모니터링 체계를 구축했다. 단일 도구에 의존하지 않고, 각 영역의 특성에 맞는 모니터링 도구를 조합하여 사각지대 없는 관측성(Observability)을 확보했다.
구성 요소
| 영역 | 도구 | 목적 |
|---|---|---|
| EC2/ECS 시스템 메트릭 | CloudWatch + Agent | CPU, 메모리, 디스크, IOPS, Task Count |
| EDI Agent 동기화 | AgentMonitor (자체 개발) | 다중 환경 Agent 상태 중앙 감시 |
| 운영 서버 Port | Port Monitor (자체 개발) | HTTP 포트 상태 2분 간격 확인 |
| ECS Fargate JVM | Prometheus + Grafana | Heap, GC, Thread, Metaspace 추적 |
| Windows 서버 프로세스 | SSM + Lambda + DynamoDB | FileReceiver 프로세스 원격 감시 |
| AWS 서비스 장애 | AWS Health + User Notifications | ECS Retirement 등 사전 감지 |
| 인프라 규정 준수 | AWS Config + Lambda 보고서 | 43개 규칙 기반 보안/성능/비용 감시 |
| 메일 수신 자동화 | SES Mail Manager + S3 + Lambda | 수신 메일 파싱 및 자동 처리 |
전체 알림 아키텍처
CloudWatch Alarm
  ├─→ SNS (Seoul) ─→ Email (운영팀)                          ← 이메일 알림
  │                ├─→ Lambda (SendSlackNotification)         ← Slack 알림
  │                └─→ Lambda (sns-forward-to-tokyo)
  │                      └─→ SNS (Tokyo) ─→ SMS              ← 문자 알림
  │
  └─→ Amazon Connect (Seoul) ─→ 아웃바운드 전화              ← 전화 알림

EventBridge Scheduler
  ├─→ Lambda (AWSConfigRulesMailProvider) ─→ SES ─→ Email     ← Config 보고서
  ├─→ Lambda (CheckWindowSvrAppStatus) ─→ SES/Slack/SMS      ← Windows 서버 점검
  └─→ Lambda (ecs-service-scale-up/down)                      ← ECS 스케줄링
1. CloudWatch 알람 기반 EC2/ECS 모니터링
EC2 인스턴스와 ECS 서비스 전반에 걸쳐 다층 알림 구조를 구성했다.
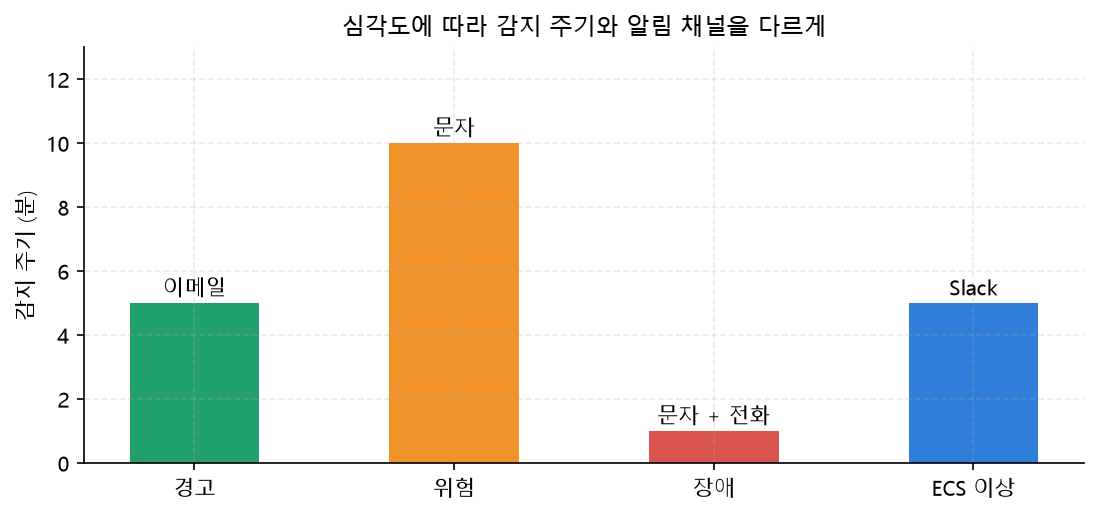
심각도별 알림 채널
| 단계 | 지속 시간 | 알림 방식 |
|---|---|---|
| 경고 (Warning) | 5분 | 이메일 |
| 위험 (Critical) | 10분 | 문자 |
| 장애 (Down) | 1분 | 문자 + 전화 |
| ECS 이상 | 5분 | Slack |
EC2 모니터링 지표
- CPUUtilization, mem_used_percent, swap_used_percent
- disk_used_percent (OS/SW 볼륨 분리)
- 평균 IOPS 사용량
- StatusCheckFailed → 1분 단위 즉시 문자 + 전화
메모리, 스왑, 디스크 지표는 CloudWatch Agent를 설치하여 수집
ECS 모니터링 지표
- CPU, Memory, Disk 사용률
- RunningTaskCount → Auto Scaling 미적용 서비스의 Task 다운 감지
→ 상세 글: CloudWatch 알람 기반 EC2/ECS 통합 모니터링 구축
2. EDI Agent 중앙 모니터링 (AgentMonitor)
여러 운영 환경에 분산된 EDI Agent들의 동기화 상태를 중앙에서 모니터링한다.
핵심 설계
- 1시간마다 상태 확인
- 6회 연속(6시간) 이상 감지 시에만 알람 → 일시적 끊김 오탐 방지
- 매일 전체 Agent 상태를 엑셀 파일(Summary + Raw Data 시트)로 정리해 자동 발송
→ 상세 글: EDI Agent 중앙 모니터링 시스템 구축
3. 운영 서버 Port 모니터링
2분 간격으로 운영 서버 포트 상태를 확인하고, 이상 감지 시 SMS/Email/전화 알람을 자동 발송한다.
| 조건 | 설명 |
|---|---|
| HTTP 응답 != 200 | 서버 오류 |
| 응답 시간 > 5초 | 과부하 또는 지연 |
| 연결 실패 (5초) | 서버 다운 |
→ 상세 글: 운영 서버 Port 모니터링 및 다중 알람 서비스 구축
→ 상세 글: AlertHub 멀티채널 알림 시스템 구축 (AWS Connect 전화 · SMS · Slack · Email)
4. ECS Fargate JVM 모니터링 (Prometheus + Grafana)
CloudWatch만으로는 보이지 않는 JVM 내부 상태를 실시간 추적한다.
도입 배경
ECS Fargate에서 OOM 발생 이력이 있었으나, CloudWatch에서는 CPU 40%, 메모리 60%로 이상 없어 보였다. 실제 원인은 Thread Leak + Heap Pressure였으며, JVM 수준 메트릭 없이는 탐지가 불가능했다.
수집 지표
| 지표 | 탐지 대상 |
|---|---|
| Heap Memory Used/Max | OOM 조기 경고 |
| GC Count/Time | Full GC 반복 감지 |
| Thread Count/Peak | Thread Leak 탐지 |
| Metaspace Used | Metaspace OOM 방지 |
아키텍처
ECS Fargate Tasks (Actuator /prometheus)
    ↓
ecs-discovery (Task 자동 감지 → ecs_file_sd.yml)
    ↓
Prometheus (메트릭 수집)
    ↓
Grafana (시각화 대시보드)
ecs-discovery 도입 효과
- Task Definition만 수정하면 자동 감지
- 서비스별 NLB 연결 방식 대비 ~$21/월 비용 절감 (9개 Task 기준)
- 관리 포인트 최소화
→ 상세 글: ECS Fargate 환경 JVM 모니터링 고도화
5. 알림 채널별 상세 구성
이메일 (Amazon SES)
SES 프로덕션 액세스를 활성화하여 샌드박스를 해제하고, 24시간 발송 한도 50,000건으로 운영 중이다. 도메인 DKIM 인증과 개별 이메일 인증을 병행하여 발송 신뢰도를 확보했다.
SES를 사용하는 Lambda 함수:
| Lambda | 용도 |
|---|---|
AWSConfigRulesMailProvider | AWS Config 규칙 평가 보고서 (평일 매일 09:00 KST) |
health-ecs-email-notify | ECS Task Retirement 대응 안내 메일 (BCC 다수 발송) |
CheckWindowSvrAppStatus | Windows 서버 앱 상태 이상 시 알림 |
→ 상세 글: Amazon SES 기반 이메일 알림 인프라 구축
문자 (SMS via Tokyo Region)
Seoul 리전은 SMS 발송을 지원하지 않으므로, Lambda를 통해 Tokyo 리전 SNS로 메시지를 포워딩하는 크로스 리전 구조를 설계했다.
CloudWatch Alarm (Seoul)
  → SNS Topic (Seoul)
    → Lambda: sns-forward-to-tokyo
      → SNS Topic (Tokyo)
        → SMS 발송 (운영팀 6명)
Tokyo SNS는 Sandbox 상태로, 사전 등록된 담당자 번호에만 발송한다. 애플리케이션 서버, DB 서버, FTP 서버, 배치 서비스의 CPU/메모리/디스크 알람이 SMS로 전달된다.
→ 상세 글: SNS SMS 크로스 리전 구성, Seoul에서 Tokyo 경유 문자 알림 발송
전화 (Amazon Connect)
Amazon Connect 인스턴스를 Seoul 리전에 구성하여 아웃바운드 전화 알림을 운영한다. StatusCheckFailed 등 즉각 대응이 필요한 장애에 사용된다.
| 항목 | 상태 |
|---|---|
| 인바운드 통화 | 비활성 |
| 아웃바운드 통화 | 활성 |
| 전화번호 유형 | TOLL_FREE (US) |
Contact Flow를 통해 CloudWatch 알람 기반 아웃바운드 전화를 자동 발신한다. 한국에서는 Amazon Connect 발신자 번호를 발급하지 않아 미국 Toll-Free 번호를 사용한다.
CloudWatch Alarm → SNS → Lambda → Amazon Connect
  → StartOutboundVoiceContact API
    → Contact Flow (TTS 음성 안내)
      → 담당자 순차 발신
→ 상세 글: AWS Connect 아웃바운드 콜 테스트 및 CloudWatch 연동 자동 전화 알림 구축
Slack (SNS → Lambda → Webhook)
ECS Task 관련 알림은 SNS → Lambda → Slack Incoming Webhook 구조로 전달된다. ALARM/OK 양방향 알림으로 장애 발생과 해소를 모두 팀에 공유한다.
# Lambda: SendSlackNotification
slack_message = {
    'text': f'{emoji} *ECS Task Alert*',
    'attachments': [{
        'color': '#ff0000' if new_state == 'ALARM' else '#36a64f',
        'fields': [
            {'title': 'Alarm', 'value': alarm_name, 'short': True},
            {'title': 'State', 'value': new_state, 'short': True},
            {'title': 'Reason', 'value': reason[:200], 'short': False},
        ]
    }]
}
ECS 외에도 Windows 서버 모니터링(CheckWindowSvrAppStatus), AlertHub(SpringBoot) 등에서 Slack 알림을 활용한다.
→ 상세 글: SNS + Lambda 기반 Slack 알림 구축
6. CloudTrail + Athena 감사 로그 분석
모니터링은 "지금 무슨 일이 일어나고 있는가"에 집중하지만, 장애 원인 추적이나 보안 감사에서는 "과거에 무슨 일이 있었는가"가 중요하다. AWS 콘솔의 이벤트 기록은 90일까지만 조회 가능하므로, CloudTrail + S3 + Athena 기반의 장기 감사 로그 분석 환경을 구축했다.
구성
AWS API 호출 → CloudTrail (추적) → S3 (JSON 로그 저장) → Athena (SQL 쿼리 분석)
| 항목 | 설정 |
|---|---|
| 이벤트 유형 | 관리 이벤트 (전 리전) + S3 데이터 이벤트 (선택적) |
| 로그 보존 | 365일 (S3 라이프사이클 자동 삭제) |
| 분석 도구 | Athena Workgroup + 저장된 쿼리 |
| 쿼리 결과 보존 | 30일 (자동 삭제) |
저장된 쿼리: 주요 감사 시나리오
| 쿼리 | 용도 |
|---|---|
console-login-history | 콘솔 로그인 이력 (성공/실패) |
root-account-activity | 루트 계정 사용 이력 |
security-group-changes | Security Group 규칙 변경 이력 |
iam-changes | IAM 사용자/정책/역할 변경 이력 |
ec2-instance-state-changes | EC2 시작/중지/종료 이력 |
api-error-events | API 호출 에러 (AccessDenied 등) |
user-activity-summary | 사용자별 API 호출 통계 |
S3 데이터 이벤트 추적
개발팀에서 Presigned URL을 통해 S3 버킷에 파일을 업로드/다운로드하는 서비스의 파일 접근 감사 요구사항이 추가되어, 특정 버킷에 대해 S3 데이터 이벤트를 선택적으로 수집하도록 확장했다. 전체 버킷이 아닌 대상 버킷만 활성화하여 비용을 최소화했다.
실제 활용 사례
ElastiCache AUTH TOKEN 로테이션 미완료로 인한 서비스 장애 발생 시, CloudTrail + Athena로 "최근 Secrets Manager 변경, ElastiCache API 변경, ECS 배포, ECR 이미지 push가 모두 없었다"는 사실을 확인하여 원인 범위를 빠르게 좁힐 수 있었다. 감사 로그는 "변경이 있었는지"뿐 아니라 "변경이 없었는지"를 확인하는 소거법의 핵심 도구로도 활용된다.
→ 상세 글: AWS CloudTrail + Athena 감사 로그 분석 환경 구축
추가 모니터링 항목
위 핵심 영역 외에도 다음 모니터링을 구축했다.
- AWS Config, 43개 규칙 기반 리소스 규정 준수 감시 → 상세 글
- EC2 StatusCheckFailed, 즉시 알람 + Auto Recovery → 상세 글
- ECS Task STOPPED 감지, RunningTaskCount 기반 Slack 알림 → 상세 글
- Windows 서버 프로세스 감시, SSM 원격 PowerShell 실행 → 상세 글
- AWS Health Dashboard, ECS Retirement 등 사전 감지 → 상세 글
- SES Mail Manager, 메일 수신 자동화 파이프라인 → 상세 글
전체 아키텍처

성과
- 전체 인프라에 대한 사각지대 없는 모니터링 체계 확립
- 심각도별 4채널 알림 분리 (이메일 → 문자 → 전화 → Slack)로 알림 피로 최소화
- 크로스 리전(Seoul → Tokyo) SMS 구조로 SMS 미지원 리전 한계 극복
- Amazon Connect 아웃바운드 콜로 야간/주말 장애 즉시 인지
- 오탐 방지 설계 (6회 연속 감지, 심각도 단계별 대응)
- JVM 수준 메트릭 추적으로 OOM/Thread Leak 조기 탐지
- 일일/주간 리포트 자동화로 운영 부담 감소
- 추가 비용 최소화 (ecs-discovery, 기존 인스턴스 활용)
배운 점
도구를 하나로 통일하려다 포기한 게 이 체계의 시작이었다. CloudWatch는 AWS 리소스를 잘 보지만 JVM 안은 못 보고, Prometheus는 JVM을 잘 보지만 AWS 측 작업 공지는 모른다. 사각지대를 없애는 방법은 도구를 통일하는 게 아니라 각 도구가 못 보는 영역을 알고 겹쳐 놓는 것이었다.
통합이라는 말의 실체도 조금 달랐다. 수집을 한 곳에 모으는 게 아니라, 알림을 한 기준으로 모으는 쪽이 실제 운영에 도움이 됐다. 수집 도구가 몇 개든 사람이 받는 신호는 심각도 하나로 정리되어야 한다.
JVM 영역을 왜 따로 봐야 했는지는 ECS Fargate 환경 JVM 모니터링 고도화에, 그 눈이 실제로 쓰인 사례는 ECS 강제 재배포 후 메모리 사용률 급증에 있다.
이어 읽기
- ECS Fargate 환경 JVM 모니터링 고도화: CloudWatch가 못 보는 영역을 채운 방법
- AWS Config 기반 인프라 규정 준수 모니터링: 장애가 아니라 설정 상태를 보는 축
- AlertHub 멀티채널 알림 시스템 구축: 알림 채널을 한 서비스로 묶은 결과