들어가며
문서 추출 모델의 성능표를 만들다가 손이 멈췄다. 표에 올리려던 숫자가 세 군데에서 왔는데, 셋 다 이름이 F1이었다.
학습 로그              eval_f1    0.9749
평가 스크립트          micro_f1   0.9792
Google Document AI     F1         (콘솔 값)
0.9749와 0.9792를 나란히 놓으면 "평가 쪽이 조금 더 잘 나왔다"로 읽힌다. 그런데 두 숫자는 애초에 같은 시험을 본 적이 없다. 채점 단위가 다르고, BIO 접두사를 다루는 방식이 다르고, 한쪽은 임계값이라는 개념 자체가 없다.
거기에 한 겹이 더 있었다. 화면에 같이 뜨는 confidence를 성능 숫자로 읽는 일이 잦았는데, 그것은 채점 결과가 아니라 모델의 자기 확신이다. 정답지가 있어야 나오는 값과 없어도 나오는 값을 한 표에 올리고 있었다.
이 글은 그 구분을 정리한 기록이다.
한 문장으로
지표가 두 종류다. 채점 결과인 F1과 모델의 자기 확신인 신뢰도다.
| 정답지 | 답하는 질문 | 쓰는 곳 | |
|---|---|---|---|
| F1 | 필요하다 | 맞았나 | 모델 버전 비교 |
| 신뢰도 | 필요 없다 | 얼마나 확신했나 | 문서별 자동 승인 판정 |
그리고 F1이라는 이름 아래에 세 가지 다른 채점기가 있다.
1. 같은 예측인데 채점 단위가 다르면 점수가 갈린다
먼저 학습 로그의 F1과 평가 스크립트의 F1이 왜 다른 숫자를 주는지부터다.
학습 쪽은 seqeval을 쓴다. BIO를 그대로 둔 채 엔티티 구간 단위로 채점한다.
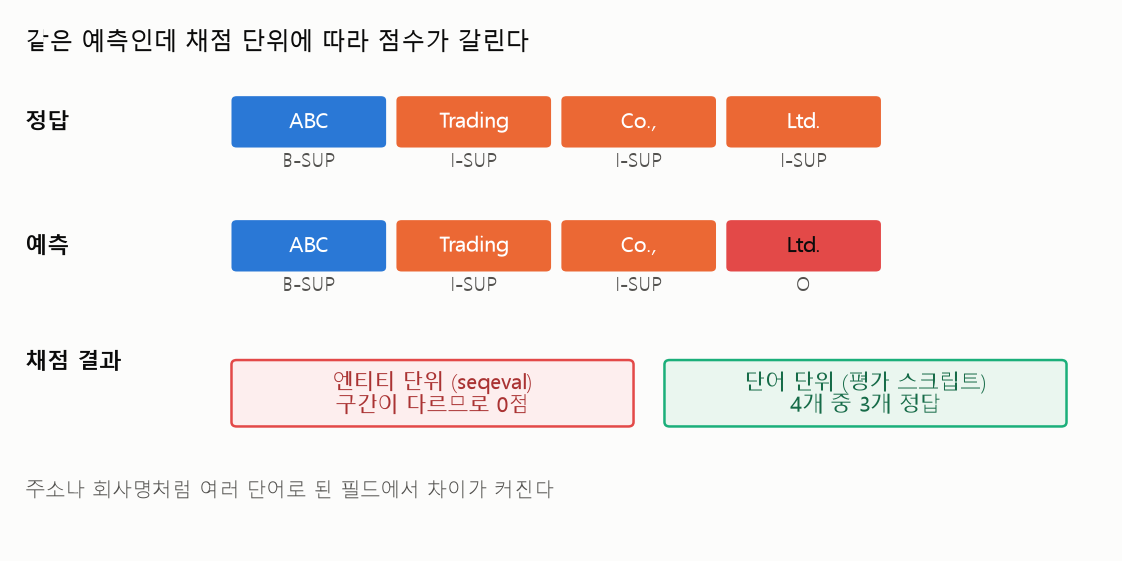
공급처명 네 단어 중 세 개를 맞히고 마지막 Ltd.만 O로 떨어뜨린 경우, 구간이 정확히 일치하지 않으므로 seqeval은 TP를 하나도 주지 않는다. FP 1 + FN 1이다. 같은 예측을 평가 스크립트에 넣으면 4개 중 3개 정답이다. BIO 접두사를 떼고 라벨만 비교하기 때문이다.
t = strip_bio_prefix(true_label)     # B-INVOICE_NUMBER → INVOICE_NUMBER
p = strip_bio_prefix(pred_label)

if t == "O" and p == "O":  continue        # 둘 다 O면 세지 않는다
if t == p:                 field_tp[t] += 1
else:
    if p != "O":           field_fp[p] += 1    # 뽑았는데 틀림
    if t != "O":           field_fn[t] += 1    # 정답을 못 맞춤
여기서 한 번 틀리면 두 번 감점된다는 점도 같이 봐야 한다. INVOICE_DATE를 DUE_DATE로 잘못 붙이면 DUE_DATE에 FP 1, INVOICE_DATE에 FN 1이 동시에 올라간다.
seqeval이 훨씬 엄격하다. 여러 줄 주소처럼 단어가 많이 묶이는 필드에서 차이가 커진다. 그래서 학습 런과 평가 런을 같은 차트에 올릴 수 없고, MLflow 실험을 kie-latin과 kie-eval로 나눈 이유가 이것이다.
seqeval이 F1과 함께 뱉는 accuracy는 쓰면 안 된다. 토큰 대부분이 O라서 아무것도 못 맞혀도 90%대가 나온다.
2. macro 평균이 0.9417에서 0.9766으로 올라간 이유
평가 런 기록을 정비하다가 이상한 값을 발견했다.
micro_f1  0.9792
macro_f1  0.9417    ← 너무 낮다
total_tp 1085   total_fp 27   total_fn 19
오답이 46건뿐인데 macro가 0.94까지 떨어질 수는 없었다. 필드별로 열어보니 원인은 customer_tax_id였다. 평가셋에 그 필드를 가진 문서가 한 건도 없었는데, F1을 0으로 세어 평균에 넣고 있었다. 제외하면 0.9766이다.
support가 0인 필드는 macro 평균에서 빼야 한다. 안 그러면 평가셋에 그 필드가 든 문서 한 건만 추가해도 macro가 뛴다. 모델이 좋아진 것이 아니라 평가셋 구성이 바뀐 것이다.
지표 이름을 macro_f1_nonzero로 바꿔 기록했다. 이름에 계산 조건을 넣어두면, 나중에 숫자만 보고 잘못 읽을 여지가 줄어든다.
micro 쪽에도 읽을 때 주의할 점이 있다. 엔티티 수가 많은 필드에 가중된다. 품목 줄이 많은 문서가 평가셋에 들어가면 품목 필드가 전체 점수를 지배한다.
3. Google Document AI는 값까지 본다
세 번째 채점기는 성격이 아예 다르다. 자체 모델 쪽 두 채점기는 둘 다 라벨만 맞으면 정답으로 센다. region_id로 정답과 예측을 짝지으므로, OCR이 읽은 글자는 양쪽이 애초에 같다.
Google Document AI는 TP 조건이 두 개다.
① entity type이 일치한다
② text value가 일치한다        ← 자체 모델에 없는 조건
②에는 fuzzy matching이 붙는다. 연속 공백은 하나로, 문장부호는 제거, 대소문자는 무시, 통화 기호도 제거한다. $1,250.00과 1250.00을 같은 값으로 본다.
여기에 임계값이 더 붙는다. 임계값보다 낮은 예측은 맞아도 무시된다. 여러 임계값에서 F1을 계산한 뒤 F1이 최대가 되는 지점을 optimal threshold로 자동 계산하고, 동률이면 더 낮은 값을 고른다.
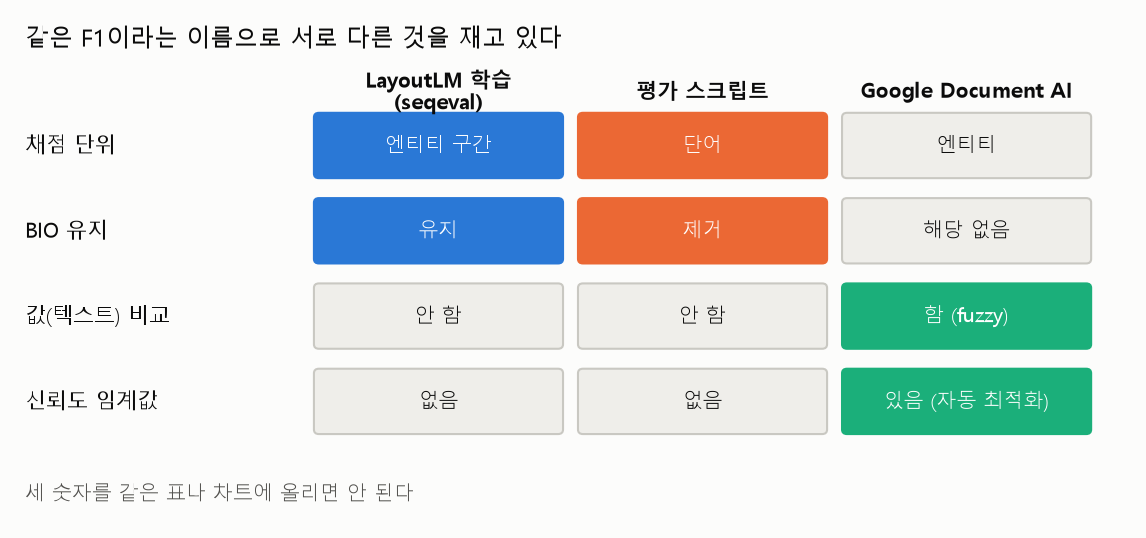
집계 방식도 다르다. Aggregate 값은 라벨 빈도로 가중하므로 micro에 가깝고, 부모 라벨은 자식의 단순 평균이 아니라 부모 임계값을 자식 전체에 적용한 뒤 합산한 값이다. 품목처럼 한 문서에 여러 번 나오는 라벨은 예측과 정답을 각각 독립적으로 대조한다.
실무적으로 무슨 뜻이냐면 이렇다.
자체 모델 F1이 높아도 값은 틀릴 수 있다. OCR이 84153.40을 854140으로 읽어도 LINEITEM_AMOUNT 라벨만 맞으면 TP다. 반면 Google Document AI의 F1은 OCR 오류까지 감점된다. end to end 성능에 더 가깝다.
그래서 두 숫자를 같은 표에 올리려면 자체 모델 쪽에도 값 비교 채점기를 붙여야 한다. region_id 매칭 대신 텍스트를 대조하는 방식이다. 아직 만들지 않았고, 그전까지 두 숫자는 나란히 놓지 않기로 했다.
4. 신뢰도는 네 층으로 쌓인다
여기부터는 정답지가 없어도 나오는 값이다. 운영 중에 매 추론마다 나오기 때문에, 자동 승인 판정의 사실상 유일한 재료가 된다.
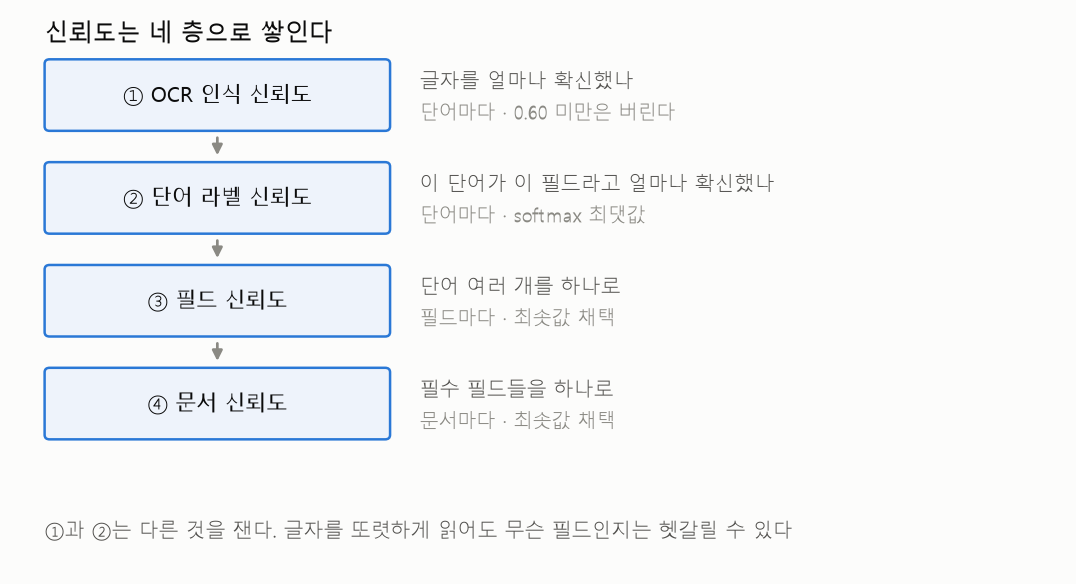
①과 ②가 다른 것을 잰다는 점이 중요하다. 글자를 또렷하게 읽었어도(① 높음) 그게 무슨 필드인지는 헷갈릴 수 있다(② 낮음). 반대도 가능하다.
① OCR 인식 신뢰도는 인식기 출력을 그대로 쓰되, 0.60 미만은 파이프라인에 들이지 않는다.
score = float(rec_scores[idx]) if idx < len(rec_scores) else None
if score is not None and score < MIN_OCR_SCORE:   # 0.60
    continue                                       # 아예 버린다
② 단어 라벨 신뢰도는 softmax 분포에서 고른 라벨의 확률값이다. 라벨이 139개면 139개 확률의 합이 1이고, 그중 최댓값을 가져온다. 여기에 처리가 둘 더 붙는다. 서브토큰으로 쪼개진 단어는 첫 조각의 값만 쓰고, 청킹 때 3단어를 겹쳐 자르므로 같은 단어가 두 번 계산되면 더 확신한 쪽을 채택한다.
③ 필드 신뢰도는 BIO로 묶인 단어들의 값을 하나로 합친다. 기본을 min으로 뒀다.
SUPPLIER_NAME = "Hansung Trading"    단어 신뢰도 0.97 · 0.62
  → min 0.62      mean 0.795      max 0.97
한 단어라도 틀리면 필드 값 전체가 틀리기 때문이다. 평균을 쓰면 0.795가 되어 통과 기준을 넘겨버린다. 세 값을 모두 기록해 두되 채택값은 min이다. 같은 기준을 필드 점수 집계에서도 쓰고 있다.
④ 문서 신뢰도는 필수 필드들 중 가장 낮은 값이다. 하나라도 불안하면 문서 전체를 불안하다고 본다. 필수가 아닌 필드는 보지 않는다.
집계 자체는 추론 스크립트에서 하지 않고 단어별 값을 그대로 백엔드로 넘긴다.
{"field": "SUPPLIER_NAME", "region_ids": ["r1"], "token_confidences": [0.97, 0.95]}집계 정책이 바뀌어도 모델을 다시 돌릴 필요가 없게 하려는 설계다.
5. 신뢰도로 검수 대상을 고를 수 없었다
정책을 다 정해놓고 실제 분포를 찍어봤다. 영문 인보이스 한 건, 필드 53개다.
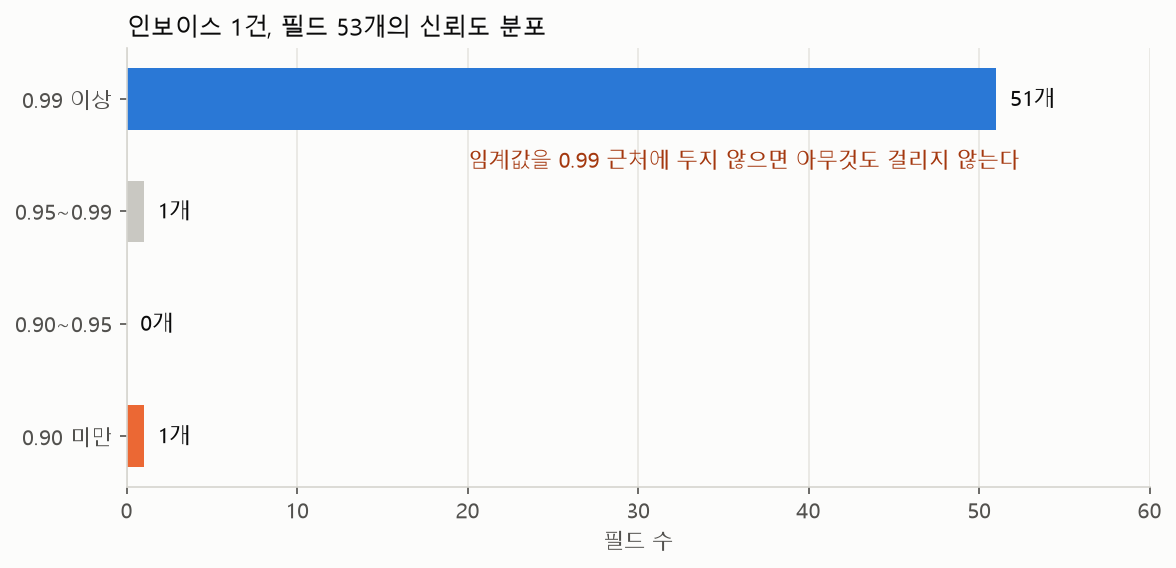
53개 중 51개가 0.99 이상이다. 토큰 분류 모델에서 흔한 포화 현상이다. 임계값을 0.95에 두면 걸리는 것이 하나도 없고, 0.99 근처로 올리면 대부분이 걸린다.
더 문제는 틀린 것도 높게 나온다는 점이었다.
POL = "MANZANILLO, C" ← 값이 잘렸는데 신뢰도 0.9839
값이 중간에서 끊겼는데 모델은 0.98 이상으로 확신하고 있었다. 신뢰도만으로 자동 승인을 판정하면 안 된다는 결론이 여기서 나왔다.
그래서 품질 점수는 신뢰도가 아니라 충족도에 무게를 실었다.
coverage = 찾은 필수 필드 수 / 전체 필수 필드 수
avg_conf = 찾은 필수 필드들의 신뢰도 평균
score    = coverage * 70 + avg_conf * 30        # 0 ~ 100
70 대 30이다. 필드를 못 찾는 것이 신뢰도가 낮은 것보다 심각하다는 판단이고, 위 분포가 그 판단의 근거다. 신뢰도는 거의 항상 높게 나오므로 변별력이 없고, required_found / required_total은 못 찾으면 그대로 떨어진다.
다만 여기에 아직 정리하지 못한 모순이 하나 있다. quality_score가 쓰는 필드별 값은 그 라벨 단어들 중 최댓값이라, ③에서 채택한 min과 방향이 반대다. 두 지표를 나란히 읽을 때 주의가 필요하고, 정리 대상으로 남겨뒀다.
참고로 Google Document AI 쪽은 신뢰도를 엔티티 하나당 하나만 준다. 단어 단위 값이 없고 집계 방식도 공개돼 있지 않다. 부모 노드의 값은 항상 1.0이라 판정에 쓸 수 없고, 문자 인식 품질은 토큰 레이어의 layout.confidence에 따로 있다.
6. OCR 인식기에는 정확도 지표가 아예 없다
ocr-rec-kor 실험에 conf_pure_korean 0.943 같은 값들이 찍혀 있어서 성능 지표로 읽고 있었는데, 열어보니 대표 샘플 이미지를 패턴당 한 장씩 추론해서 나온 confidence였다. 정확도가 아니다.
| 측정하는 것 | 얼마나 확신했나 |
| 측정하지 않는 것 | 맞았나 |
| 표본 수 | 패턴당 1장 |
검증표를 다시 보니 모든 항목이 정답과 일치했다. confidence가 낮게 나온 항목도 글자는 맞게 읽었다. 즉 숫자가 떨어진 것을 성능 하락으로 읽고 있었던 셈이다.
필요한 것은 따로 있다.
고정 테스트 이미지 세트 N장
  → 문자 정확도(CER) 또는 완전일치율(Exact Match)
  → 패턴별(한글 · 쉼표 · 소수점 · 혼합)로 나눠 집계
CER은 문자 단위 오류율이라 OCR에서 표준으로 쓰인다. conf_*는 참고값으로만 남기고 판정에는 쓰지 않는 것이 맞다. 한글 OCR 파인튜닝 라운드에서 라운드마다 검증표를 눈으로 확인해야 했던 것도 이 지표가 없어서였다.
7. 지금 상태로 남겨둔 것
| 항목 | 상태 |
|---|---|
| 고정 평가셋 | 미착수. 이것이 없으면 위 모든 숫자가 참고값이다 |
| macro 평균 support 0 제외 | 평가 런에는 반영. 스크립트 기본값은 아직 |
| OCR 인식 정확도 지표(CER · Exact Match) | 미착수. 현재 지표 자체가 없음 |
| 자체 모델 값 비교 채점기 | 미착수. Google Document AI와 비교하려면 필요 |
| 세 방식의 숫자를 같은 차트에 올리지 않기 | MLflow 실험 분리로 반영 완료 |
| 신뢰도 임계값 실측 결정 | 미착수. 53개 중 51개가 0.99 이상이라 현재 임계값이 무의미 |
가장 위의 항목이 나머지를 다 막고 있다. 고정 평가셋이 없으면 버전 간 비교가 성립하지 않으므로, 지표를 아무리 정교하게 정의해도 결론을 낼 수 없다. 고정 벤치마크를 먼저 만들어야 한다고 적어둔 것이 이 이유다.
배운 점
같은 이름이 같은 것을 뜻한다고 가정하면 안 된다. F1이라는 이름이 세 군데에 있었고, 셋 다 다른 것을 재고 있었다. 이름이 겹친다는 이유로 한 표에 올린 것이 문제의 시작이었다. 지표를 옮길 때 가장 먼저 확인할 것은 값이 아니라 계산 조건이다.
지표 이름에 계산 조건을 넣으면 오독이 줄어든다. macro_f1을 macro_f1_nonzero로 바꾼 것만으로 "support 0을 뺐는가"를 매번 확인할 필요가 없어졌다. 문서에 적어두는 것보다 이름에 적어두는 쪽이 오래 간다.
정책을 정했으면 실측으로 확인해야 한다. 신뢰도 임계값 정책은 논리적으로 흠이 없었는데, 실제 분포를 찍어보니 53개 중 51개가 0.99 이상이라 임계값이 작동할 자리가 없었다. 값이 잘린 필드조차 0.98을 넘겼다. 설계가 맞는지는 코드가 아니라 데이터가 알려준다.
정확도가 아닌 값을 정확도로 읽는 일이 생각보다 흔하다. confidence는 채점 결과가 아니라 자기 확신이다. 0.96이 "96% 맞다"는 뜻이라는 보장은 어디에도 없다. 정답지 없이 나오는 숫자는 정답 여부를 말할 수 없다는 것이, 당연한데도 계속 헷갈리는 지점이었다.
참고 자료
- seqeval: 엔티티 구간 단위 채점 구현
- CoNLL-2003 Shared Task: 엔티티 단위 P/R/F1의 표준 정의
- Google Document AI: Evaluate a processor: TP 판정 조건과 optimal threshold
- Guo et al., 2017. On Calibration of Modern Neural Networks: 신경망의 confidence가 정확도와 어긋나는 현상
- Levenshtein distance: CER 계산의 기반
이어 읽기
- 실험을 네 개로 나눈 이유: MLflow로 모델 계보와 비교 가능성을 관리한 기록: 이 글의 지표들이 어느 실험에 어떻게 기록되는지
- 무엇으로 잘한다고 말할 것인가: 평가 지표와 고정 벤치마크: 고정 평가셋이 없으면 모든 숫자가 참고값이 되는 이유
- B-SUPPLIER_NAME은 누가 봐야 하나: BIO 태깅의 경계를 정한 기록: 필드 신뢰도를 최솟값으로 정한 같은 기준
- 정확도 99.97%인데 쓸 수 없던 모델: 한글 OCR 파인튜닝 6라운드: 지표가 없어 검증표를 눈으로 확인해야 했던 과정
- 청크 193개가 7개로: LayoutLM 청킹 설계와 추론 속도 개선: 겹친 청크에서 신뢰도 최댓값을 채택하는 이유