모델을 만드는 것과 모델을 측정하는 것은 완전히 다른 일이다.
Document AI 프로젝트가 어느 정도 궤도에 오르면서, 이제는 "모델 개발 중심 단계"에서 "측정 가능한 ML 시스템 단계"로 넘어가야 할 시점이 왔다. 이 글에서는 성능 측정 체계를 0단계부터 단계별로 구축한 과정을 정리한다.
0단계: 기준 먼저 고정
성능 측정에서 가장 먼저 해야 할 일은 기준을 고정하는 것이다. 이걸 안 하면 지표가 다 무의미해진다.
평가 대상 필드 목록 확정
모든 라벨을 성능 핵심 지표에 넣기보다는, 핵심 필드 셋을 먼저 정하는 게 중요하다.
핵심 필드
INVOICE_NUMBER
INVOICE_DATE
DUE_DATE
CUSTOMER_NAME
CUSTOMER_ADDRESS
CUSTOMER_TAX_ID
CUSTOMER_CODE
SUPPLIER_NAME
SUPPLIER_ADDRESS
BL_NUMBER
POL
POD
VESSEL_VOYAGE
보조 필드 (있으면 좋지만 핵심 KPI에서는 한 단계 덜 중요)
CONTAINER_NUMBER, CONTAINER_SIZE_TYPE, SERVICE_TYPE,
PCD_DATE, SERVICE_CONTRACT_NUMBER, ERD_DATE,
TOTAL_AMOUNT, CURRENCY, LINEITEM_DESCRIPTION, ...
텍스트 정규화 규칙
문서 AI에서는 문자열이 완전히 같지 않아도 실제로는 같은 값인 경우가 많다.
2026-03-19 / 2026.03.19 / 2026/03/19
12 ,500.00 / 12500.00
(주)한빛상사 / ㈜한빛상사
abc trading / ABC TRADING
이걸 전부 틀렸다고 보면 성능이 지나치게 낮게 나오고, 반대로 너무 느슨하게 보면 성능이 부풀려진다. 그래서 raw와 normalized 비교를 분리해야 한다.
공통 normalize
- 앞뒤 공백 제거
- 연속 공백 1칸으로 축소
- 영문 대문자 통일
- 줄바꿈 제거 또는 공백 처리
특수문자 normalize
- ㈜ → (주)
- 전각 쉼표/콜론 → 반각으로 변환
숫자/금액 normalize
- 쉼표 제거
- 통화기호 제거 가능
- 불필요한 공백 제거
필드별 비교 규칙
모든 필드를 같은 방식으로 비교하면 안 된다. field type별 비교 규칙을 정해야 한다.
| 필드 타입 | 예시 | 비교 규칙 |
|---|---|---|
| ID/번호형 | INVOICE_NUMBER, BL_NUMBER | 매우 엄격, 공백 제거 정도만 허용, 오탈자 1글자로 불일치 처리 |
| 날짜형 | PCD_DATE, ERD_DATE | -, ., / 차이 허용, zero-padding 통일, 가능하면 날짜 포맷 파싱 후 비교 |
| 금액형 | TOTAL_AMOUNT | 쉼표 제거, 통화기호/소수점 자릿수 정책 정의 |
| 일반 문자열 | CUSTOMER_NAME | 대소문자 무시, 연속 공백 무시, 일부 특수기호 normalize |
데이터셋 split 규칙
계속 실험하다 보면 성능이 좋아진 게 진짜 모델 덕분인지, test 셋이 쉬워서 그런 건지 헷갈릴 수 있다. 그래서 train/val/test 분할 기준을 고정해야 한다.
추천 비율: train 70, val 15, test 15
여기서 중요한 포인트는 Document AI는 같은 양식이 train/test에 섞이면 성능이 과대평가되기 쉽다는 점이다.
- 1차: 랜덤 split으로 빠르게 baseline 구축
- 2차: 템플릿/고객사 기준 분할 (hard/generalization test), 비슷한 문서끼리 train/test에 섞지 말고 아예 그룹째로 나누기
데이터셋 버전 naming 규칙
정답 데이터셋이 계속 바뀌면 "이 실험이 어떤 데이터 기준인지"를 모르게 되어 비교가 어렵게 된다. export할 때마다 버전명을 규칙적으로 만들어야 한다.
ls_export_2026-03-19_proj34_v1
ls_export_2026-03-19_proj34_v2
ls_export_2026-03-19_invoice_mix_v1
포함하면 좋은 정보: export 날짜, project id 또는 dataset 이름, 버전 번호. 추가로 schema version과 corrected_text 반영 여부도 있으면 좋다.
1단계: OCR 성능 측정
목표
Tesseract vs PaddleOCR 정량 비교. ocr_text와 corrected_text를 비교하여 다음 4가지 지표를 산출한다.
- CER (문자 오류율)
- WER (단어 오류율)
- Exact Match
- Normalized Match
전체 흐름
Label Studio corrected_text (정답)
        vs
OCR 결과 (Tesseract / PaddleOCR)
        ↓
    문자 비교
        ↓
  CER / WER / EM 계산
        ↓
  결과 저장 (json / csv)
Label Studio에서 정답 만들기
Label Studio상에서 30개 문서를 검수한다.
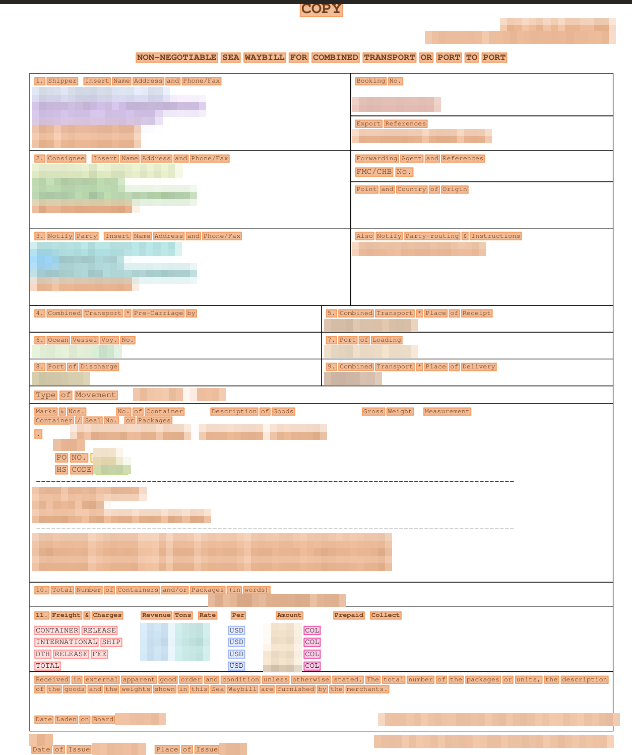
모델의 추론 결과를 Label Studio에 불러오면 위처럼 단어 영역마다 라벨 색이 칠해진 상태로 뜬다. 같은 색은 같은 필드다. 송하인 이름과 주소처럼 여러 줄에 걸친 값은 영역 여러 개가 같은 색으로 묶이고, 하단 운임표는 항목명, 요율, 통화, 금액이 각각 다른 색으로 나뉜다. 검수자는 빈 문서에 처음부터 라벨을 그리는 게 아니라, 모델이 칠해둔 것을 보고 틀린 곳만 고친다. (식별 정보가 담긴 영역은 모자이크 처리했다.)
- OCR Text만 기준으로 검수
- OCR text가 실제 원본 text와 다르게 추출된 경우 Label Studio의 Regions탭의 '정답 텍스트 입력'에 고쳐쓰기
- 전체 필드에 대해 모두 검수하면 시간이 너무 오래 걸리니 대표 10개 필드에 대해서만 적용
- 동일한 경우 '정답 텍스트 입력'에 동일 텍스트 입력
비교 스크립트 작성 및 실행
paddle_env 가상환경에서 실행한다.
source paddle_env/bin/activate
pip install rapidfuzz
비교용 추출 코드와 평가 코드를 작성한다.
python3 extract_ocr_vs_corrected.py   # OCR 결과 + corrected_text 비교 가능한 형태로 추출
python3 evaluate_ocr.py               # CER/WER/EM 계산
실행 결과물:
ocr_vs_corrected.json, 중간 결과 (비교 가능한 형태로 정리)ocr_eval_detailed.json, 각 region마다 CER, WER, exact_match, normalized_matchocr_eval_summary.json, 필드별/전체 평균 CER/WER/EM/NEM
OCR 성능 측정 결과 (30개 데이터 기준)
| 항목 | 값 |
|---|---|
| 총 샘플 수 | 370 |
| CER | 0.0155 (≈ 1.55%) |
| WER | 0.0155 |
| Exact Match | 98.92% |
| Normalized Match | 98.92% |
전체 OCR 성능은 매우 높게 나왔다. 하지만 필드별로 보면 차이가 있다.
CUSTOMER_NAME
{
  "count": 30,
  "cer": 0.159,
  "exact_match_rate": 0.933
}
→ CER 15.9%, EM 93.3%, 한글 이름에서 OCR 오류 발생
SUPPLIER_ADDRESS
{
  "count": 26,
  "cer": 0.0368,
  "exact_match_rate": 0.923
}
→ CER 3.6%, EM 92.3%, 긴 주소 문자열에서 OCR 깨짐 발생
나머지 필드(INVOICE_NUMBER, INVOICE_DATE, DUE_DATE, CUSTOMER_CODE, VESSEL_VOYAGE, POL, POD, BL_NUMBER 등)는 모두 CER 0.0, Exact Match 100%로 완벽한 성능을 보였다.
2단계: LayoutLM (KIE) 성능 측정
목표
checkpoint 성능을 숫자로 확인한다. predicted label과 human-reviewed label을 비교한다.
- GT(정답): Label Studio에서 사람이 검수해서 최종 확정한 label
- Pred(예측): predictions 안에 들어 있는 LayoutLM 예측 label
측정 지표
- Precision (정확도), 내가 맞다고 한 것 중에서 실제로 맞은 비율 = TP / (TP+FP)
- Recall (재현율), 실제로 있는 것 중에서 얼마나 찾아냈는지 = TP / (TP+FN)
- F1-score, Precision과 Recall의 균형 점수 = 2 × (P × R) / (P + R)
- per-label 성능, 각 필드별로 따로 평가
- overall micro / macro F1
F1-score가 중요한 이유
좋은 모델의 경우..
Precision 높음 → 헛다리 적음
Recall 높음   → 놓치는 것 적음

나쁜 모델의 경우..
Precision만 높음 → 데이터 누락
Recall만 높음   → 데이터 오염
결과물: kie_eval_summary.json, per_label_metrics.json
3단계: 문서 단위 점수 (운영 KPI)
목표
"이 문서 자동 처리 가능한가?"를 판단한다.
- field별 가중치 정의
- 문서별 score 계산
- A / B / C / D grade 계산
- auto-pass 기준 정의 (예: A만 통과)
집계 항목: auto-pass rate, review rate, fail rate, 평균 필드 정확도
결과물: doc_eval_summary.json, doc_scores.csv
4단계: bbox 품질 측정
목표
"박스 날아다니는 문제 잡기"
- IoU 계산 함수 작성
- bbox match rate 계산 (IoU ≥ 0.5)
- 평균 IoU 계산
- text correct + bbox correct 동시 만족 계산
결과물: bbox_eval.json
5단계: 오답 분석 자동화
목표
왜 틀리는지 보이게 만들기
- wrong cases CSV 생성
- 필드별 오답 저장
- error_type 분류
컬럼: doc_id, field, gt, pred, normalized_equal, error_type
결과물: wrong_cases.csv
6단계: MLflow 도입
목표
실험 기록 자동화. MLflow Tracking Server를 구축하여 모든 실험을 추적 가능하게 만든다.
MLflow 서버 구축
# 디렉토리 구조 생성
mkdir -p /home/user/mlflow/{artifacts,db,logs}

# Python 가상환경 생성
python3 -m venv mlflow_env
source mlflow_env/bin/activate

# MLflow 설치
pip install --upgrade pip
pip install "mlflow[extras]"
mlflow --version
MLflow 서버 실행
nohup mlflow server \
  --host 0.0.0.0 \
  --port 5001 \
  --backend-store-uri /home/user/mlflow/mlruns \
  --default-artifact-root file:///home/user/mlflow/artifacts \
  > /home/user/mlflow/logs/mlflow.log 2>&1 &
서버 확인:
ps -ef | grep mlflow
tail -f /home/user/mlflow/logs/mlflow.log
netstat -tulnp | grep 5001
브라우저에서 [서버IP]:5001로 접속하여 MLflow UI를 확인할 수 있다.
평가 코드에 MLflow 연동
환경 변수 설정:
export MLFLOW_TRACKING_URI=http://127.0.0.1:5001

# 영구 반영
echo 'export MLFLOW_TRACKING_URI=http://127.0.0.1:5001' >> ~/.bashrc
source ~/.bashrcevaluate_ocr.py에 MLflow 기록 코드를 추가한다.
import mlflow
from mlflow_common import setup_mlflow

with mlflow.start_run(...):
    # param / metric / artifact 기록
실행하면 MLflow UI에서 experiment별로 OCR 성능 지표(CER, WER, EM 등)를 필드별로 확인할 수 있다.
7단계: MLflow 코드 연결
모든 실험 기록을 남기기 위해 다음 항목들을 MLflow에 기록한다.
mlflow.set_tracking_uri설정- param logging: dataset_version, ocr_engine, checkpoint
- metric logging: cer, wer, f1, exact_match, auto_pass_rate
- artifact 업로드: 평가 결과 JSON/CSV 파일
8단계: 파이프라인 연결
최종 목표는 완전 자동화다.
- OCR → 평가 자동 실행
- LayoutLM → 평가 자동 실행
- End-to-End 평가 자동 실행
- MLflow 자동 기록
우선순위
지금 당장 해야 할 TOP 3:
- OCR CER/WER/EM 계산, OCR 엔진 교체 효과를 숫자로 확인
- field-level Precision / Recall / F1 계산, LayoutLM 모델 성능 정량화
- 문서 auto-pass rate 계산, 운영 관점에서 자동 처리 가능 비율 확인
이 3개만 있어도 이미 "모델 비교 가능한 상태"가 된다.
정리
지금 시점에 필요한 건 모델 개선이 아니라 **"측정 체계 구축"**이다.
기준을 먼저 고정하고(0단계), OCR 성능을 정량화하고(1단계), LayoutLM KIE 성능을 측정하고(2단계), 문서 단위 운영 KPI를 만들고(3단계), MLflow로 실험을 추적 가능하게 만드는(6~7단계) 것이 전체 흐름이다.
측정 없이는 개선도 없다. 측정 체계가 갖춰지면 모델 교체, 하이퍼파라미터 튜닝, 데이터 추가 등 모든 실험의 효과를 객관적으로 비교할 수 있게 된다.
배운 점
측정 체계를 만들면서 가장 많이 한 일은 지표 계산이 아니라 기준 고정이었다. 무엇을 핵심 필드로 볼지, 어떤 데이터로 잴지를 정하지 않으면 지표는 매번 다른 것을 재게 된다. 그러면 숫자는 나오는데 비교는 안 된다.
MLflow를 붙인 이유도 같다. 실험이 늘어나면 사람은 어떤 설정에서 그 숫자가 나왔는지 잊는다. 기록되지 않은 실험은 없었던 실험과 같다.
이 흐름은 이후 무엇으로 잘한다고 말할 것인가: 평가 지표와 고정 벤치마크에서 고정 벤치마크로 정리됐고, 무엇을 나눠서 재야 하는지는 양식, 언어, 입력 형태로 나눠 테스트한 이유에 이어진다.
이어 읽기
- 무엇으로 잘한다고 말할 것인가: 평가 지표와 고정 벤치마크: 기준을 고정한 최종 형태
- 양식, 언어, 입력 형태로 나눠 테스트한 이유: 평균 뒤에 가려진 약점을 찾는 방법
- 실험을 네 개로 나눈 이유: MLflow로 모델 계보와 비교 가능성을 관리한 기록: MLflow 기록 규약을 정비한 후속 작업
- F1이 세 개였다: 같은 이름으로 다른 것을 재고 있었던 기록: 측정 체계에서 쓰는 지표들의 계산 조건 정리