물류와 무역 문서에서 필드를 자동으로 뽑아내는 서비스를 맡았다. 인보이스, 선하증권, 세무 문서가 대상인데, 같은 인보이스라도 발행처마다 양식이 전부 다르다.
이 글에서는 모델을 고르기까지의 과정을 정리한다. 왜 한 번에 끝내는 모델 대신 두 단계로 나눴는지, 그리고 각 단계에서 무엇을 기준으로 골랐는지다.
문제: 양식이 제각각이다
문서 자동화에서 가장 먼저 부딪히는 건 "같은 종류의 문서인데 생김새가 다 다르다"는 점이다.
같은 "인보이스"라도
  A 발행처: 상단에 요금 테이블, 하단에 항목 세부
  B 발행처: 좌측에 주소 블록, 우측에 금액 요약
  C 발행처: 표 테두리 없이 줄바꿈만으로 항목 구분
필드 위치를 좌표로 고정하는 방식(템플릿 매칭)은 양식이 하나 늘어날 때마다 규칙을 새로 써야 한다. 서비스로 만들려면 모델이 문서의 생김새를 보고 판단해야 했다.
한 번에 끝내는 모델을 쓰지 않은 이유
문서 이미지를 넣으면 바로 결과 JSON이 나오는 방식(end-to-end)도 후보였다. 상용 Document AI 서비스와 LLM·VLM 계열이 여기에 해당한다.
서비스 요건을 기준으로 비교한 결과는 이렇다.
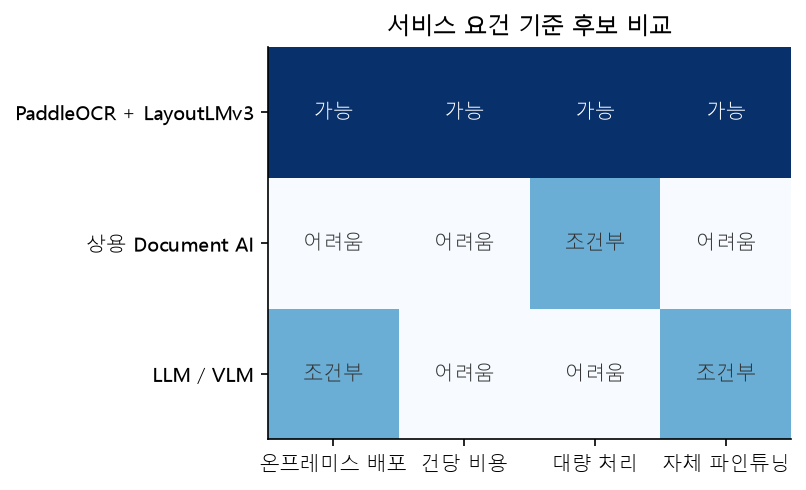
| 요건 | 왜 필요한가 |
|---|---|
| 온프레미스 배포 | 고객사 문서를 외부로 보낼 수 없는 경우가 있음 |
| 건당 비용 | 문서가 대량으로 들어오는 서비스라 건당 과금이 그대로 원가가 됨 |
| 대량 처리 | 배치로 수백 건을 한 번에 처리해야 함 |
| 자체 파인튜닝 | 새 양식이 들어올 때마다 우리 데이터로 학습시킬 수 있어야 함 |
상용 서비스는 온프레미스 요건에서, LLM·VLM은 건당 비용과 대량 처리에서 본선에 들어오기 어려웠다. 다만 완전히 배제하지는 않았다. 모델 선택 UI의 옵션으로 두어, 특수한 문서에는 보조 수단으로 쓸 수 있게 설계했다.
한 번에 끝내는 방식의 매력과 대가
공정하게 말하면 end-to-end 방식에는 분명한 장점이 있다. 단계가 하나뿐이라 앞 단계의 오류가 뒤로 전파되지 않는다. 두 단계로 나누면 OCR이 글자를 잘못 읽는 순간 뒤에서 아무리 잘해도 값이 틀린다. 이 구조적 약점은 나눈 쪽이 감수해야 하는 부분이다.
그런데 서비스 관점에서 보면 대가가 따라온다.
| 항목 | 두 단계 (OCR + NER) | 한 번에 (end-to-end) |
|---|---|---|
| 오류 전파 | OCR 오류가 뒤로 이어진다 | 없다 |
| 틀렸을 때 원인 파악 | 어느 단계인지 구분된다 | 모델 안에서 일어나 알기 어렵다 |
| 부분 개선 | 한 단계만 다시 학습 | 전체를 다시 학습 |
| 사람의 개입 | 중간 결과를 보여주고 고칠 수 있다 | 최종 결과만 고칠 수 있다 |
마지막 항목이 결정적이었다. 우리 서비스에는 검수 단계가 있고, 사람이 고친 값을 다시 학습에 쓴다. 중간 결과(읽은 글자와 좌표)가 눈에 보여야 "글자를 잘못 읽은 것"과 "필드를 잘못 붙인 것"을 나눠서 고칠 수 있다. 정확도가 100%가 아닌 이상 사람이 붙어야 하고, 그렇다면 사람이 개입하기 좋은 구조인지가 모델 성능만큼 중요한 조건이 된다.
두 단계로 나누기
결국 파이프라인을 두 단계로 나눴다.
[1단계] PaddleOCR            [2단계] LayoutLMv3
문서 이미지 → 텍스트 + 좌표   →  각 단어가 어떤 필드인지 분류
(무엇이 어디에 쓰여 있나)        (그 값이 INVOICE_NO인가 VESSEL인가)
나누면 좋은 점이 분명했다.
- 단계별로 독립 교체가 가능하다. OCR 엔진을 바꿔도 뒤쪽 분류 모델은 그대로 둘 수 있다.
- 실패 지점이 분리된다. 값이 틀렸을 때 글자를 잘못 읽은 건지(OCR), 필드를 잘못 붙인 건지(NER) 구분된다.
- 사람이 고칠 자리가 생긴다. OCR이 글자를 잘못 읽으면 검수 화면에서 정답 텍스트를 입력하고, 그 수정본이 다시 학습에 쓰인다.
1단계: PaddleOCR
Detection(텍스트 영역 찾기)과 Recognition(그 안의 글자 읽기)으로 다시 나뉜다.
| 구분 | 모델 | 파인튜닝 | 비고 |
|---|---|---|---|
| Detection | PP-OCRv5_server_det (83.9MB) | 불필요 | 언어와 무관하게 영역만 찾으므로 공통 사용 |
| Recognition (영문) | latin_PP-OCRv3_mobile_rec | 불필요 | 숫자, 쉼표, 소수점, $ 인식이 기본 모델로 충분 |
| Recognition (한국어) | korean_PP-OCRv3_mobile_rec | 필요 | 숫자·쉼표 인식 보강을 위해 6라운드 진행 |
Detection은 "글자가 어디 있나"만 보기 때문에 언어를 타지 않는다. 반면 Recognition은 언어별로 다르다. 영문은 기본 모델로 충분했지만 한국어는 그렇지 않았고, 그 과정은 다음 글에서 따로 다룬다.
Tesseract에서 PaddleOCR로
처음에는 Tesseract를 쓰고 있었다. 한국어 인식 정확도가 한계였고, PaddleOCR로 바꾸면서 두 가지를 확인해야 했다.
- 기존에 학습해 둔 분류 모델이 새 OCR 출력에 적응하는가, OCR 엔진이 바뀌면 텍스트 분할 단위와 좌표 체계가 달라진다. 약 70건의 데이터를 추가로 학습시켜 적응 가능함을 확인했다.
- 중복 검출 문제, PaddleOCR이 같은 영역을 여러 번 잡는 경우가 있었다. Detection 파라미터를 조정하고, IoU 기반 중복 제거를 후처리로 넣어 해결했다.
2단계: LayoutLMv3
필드 분류는 LayoutLMv3로 했다. 이 모델을 고른 이유는 문서를 세 가지 신호로 동시에 본다는 점이다.
| 입력 | 무엇을 보는가 |
|---|---|
| 텍스트 | 그 단어가 무엇이라고 쓰여 있는지 |
| bbox | 문서 안 어디에 있는지 (0~1000으로 정규화한 좌표) |
| 이미지 패치 | 주변이 시각적으로 어떻게 생겼는지 (표 안인지, 로고 옆인지) |
문서는 위치가 의미를 갖는다. 같은 숫자라도 상단 우측에 있으면 인보이스 번호이고, 표 안에 있으면 금액이다. 텍스트만 보는 모델로는 이 구분이 어렵다.
출력은 토큰 분류(token classification)이다. 각 단어에 라벨을 붙이는 방식이라, 라벨을 추가하면 분류 레이어만 확장하면 된다. 실제로 라벨은 서비스가 커지며 33개에서 89개, 다시 139개까지 늘었지만 구조를 바꿀 필요는 없었다.
결과적으로 얻은 구조
문서 업로드
   ↓
PaddleOCR (Detection → Recognition)      ← 언어별 Recognition 분기
   ↓  텍스트 + bbox
LayoutLMv3 토큰 분류                       ← 도메인별 checkpoint 분기
   ↓  필드별 값 + 신뢰도
검수 화면 (사람이 확인·수정)
   ↓
확정 데이터 + 다음 학습 데이터
검수에서 사람이 고친 값이 다시 학습 데이터가 되는 구조가 핵심이다. 서비스를 쓸수록 데이터가 쌓이고, 그 데이터로 다음 라운드를 학습한다.
배운 점
두 단계로 나눈 결정은 계속 옳았다. 이후에 OCR 쪽에서 한글 파인튜닝을 여섯 번 돌리고, NER 쪽에서 청킹 구조를 바꾸고 이미지 입력을 추가하는 큰 변경이 여러 번 있었는데, 그때마다 반대쪽은 건드리지 않아도 됐다. 한 덩어리였다면 매번 전체를 다시 검증해야 했을 거다.
"되는 것"과 "서비스에 쓸 수 있는 것"은 다르다는 걸 배웠다. 상용 서비스나 LLM은 데모에서 잘 동작한다. 그런데 온프레미스 배포가 필요한 고객이 있고, 문서가 대량으로 들어오면 건당 비용이 곧 원가가 된다. 기술을 고를 때 정확도만 보면 이 조건들이 보이지 않는다.
아쉬운 점은 초기 평가 기준이었다. 처음에는 "이 모델이 우리 문서를 얼마나 잘 읽나"만 봤다. 나중에야 온프레미스, 비용, 파인튜닝 가능성 같은 조건을 표로 정리했는데, 이 표를 처음부터 만들었다면 후보를 더 빨리 좁힐 수 있었을 것이다. 무엇을 기준으로 고를지 정하는 일이 후보를 조사하는 일보다 먼저였다.
사람이 개입할 자리를 남기는 것도 설계였다. 정확도가 100%가 아닌 서비스에서는 검수가 반드시 따라붙는다. 그렇다면 모델을 고를 때 "사람이 어디를 어떻게 고칠 수 있는가"도 조건이 된다. 실제로 이 구조 덕분에 검수에서 고친 값이 다음 학습 데이터가 되는 순환이 만들어졌다.
구조를 나눠두면 고칠 곳도 나뉜다. OCR과 NER이 한 덩어리였다면 한글 인식을 고치려고 전체를 다시 학습시켜야 했다. OCR만 교체한 기록이 PaddleOCR 도입기, 인식기만 여섯 라운드 손본 기록이 한글 OCR 파인튜닝 6라운드, 분류 쪽 입력 구조만 바꾼 기록이 LayoutLM 청킹 설계다. 세 번의 큰 변경에서 매번 반대쪽은 그대로 뒀다.
이어 읽기
- PaddleOCR 도입기: Tesseract에서 PaddleOCR로의 전환: OCR 단계만 교체한 사례
- AI Document Processing Pipeline (OCR + LayoutLM): 이 선택이 놓인 전체 파이프라인
- 양식, 언어, 입력 형태로 나눠 테스트한 이유: 선정한 구조를 검증한 방법