들어가며
문서 AI 모델을 서비스에 붙여 운영하면 파인튜닝을 "한 번 크게" 하고 끝내는 경우는 없다. 새로운 거래처 양식, 새로운 언어, 없던 필드가 계속 들어오기 때문에 학습은 자연스럽게 여러 라운드로 나뉜 반복 구조가 된다.
이 글은 그 반복 구조에서 기존 능력을 잃지 않기 위해 쓴 두 가지 방법에 대한 기록이다.
왜 한 번에 크게 학습하지 않는가
데이터를 다 모아서 한 번에 학습시키는 쪽이 깔끔해 보인다. 그런데 실무에서는 성립하지 않는다. 어떤 신규 포맷이 들어올지 만나기 전에는 알 수 없기 때문이다.
| 대안 | 왜 안 되는가 |
|---|---|
| 데이터를 모아 한 번에 대량 학습 | 고객 문서 유입에 따라 데이터가 점진적으로 생김. 예측 불가한 포맷을 만날 때마다 흡수하는 구조가 필요 |
| LLM·VLM으로 대체 | 건당 비용과 온프레미스 요건상 본선이 아닌 보조 수단 |
반복 구조의 실질적인 장점은 실패 비용이 싸다는 것이다. 한 번에 크게 갔다가 잘못되면 되돌리기 어렵지만, 소규모 라운드는 결과가 나쁘면 원인을 분석해 다음 라운드에서 보완하면 된다.
반복 학습의 함정: 새로 배우면서 잊는다
문제는 "이어서 학습"이 공짜가 아니라는 점이다. 신경망에 새 데이터를 학습시키면 가중치가 새 데이터 쪽으로 움직인다. 이때 학습 데이터에 없다는 이유만으로 기존에 잘하던 것을 잊는 현상이 생긴다. catastrophic forgetting이다.
기존 도메인에서 F1 97%를 내던 모델에 새 도메인 데이터만 넣고 이어 학습시키면, 새 도메인은 오르지만 기존 도메인이 떨어질 수 있다.
더 곤란한 건 떨어진 걸 모를 수 있다는 점이다. 새 라운드의 평가는 대개 새 데이터로 하기 때문에, 그 지표는 올라간 쪽만 보여준다. 기존 도메인이 나빠졌는지 확인하려면 매 라운드 같은 자로 재는 장치가 따로 있어야 한다. 망각은 감지 수단이 있어야 존재하는 문제다.
해법 1: 누적 학습 (Rehearsal)
가장 단순하고 확실한 방법은 새 라운드에 기존 데이터를 버리지 않고 포함시키는 것이다.
라운드 1: 도메인 A 100건으로 학습
라운드 2: 도메인 A 100건 + 도메인 B 신규 200건 = 300건으로 학습
모델이 새 데이터로 이동하는 동안에도 기존 데이터가 계속 섞여 들어오면, "이 능력도 유지해야 한다"는 신호가 매 스텝 함께 주어진다. 새 과목을 배우면서 예전 과목도 복습하는 것과 같아서 rehearsal이라는 이름이 붙었다.
주의할 점은 라운드를 거듭할수록 학습 시간이 길어진다는 것이다. 라운드마다 데이터가 더해지므로 학습 시간은 누적 데이터 양을 따라간다. 지금 규모에서는 감당되지만, 누적이 수천 건이 되면 전체를 넣는 대신 대표 샘플만 뽑는 방식으로 바꿔야 한다.
그 시점을 언제로 볼지도 미리 정해두는 게 좋다. 한 라운드 학습 시간이 하루 안에 결과를 볼 수 없는 수준이 되면, 실험 횟수가 줄고 그만큼 개선 속도가 느려진다. 학습 시간은 성능 지표가 아니지만 개선 속도를 좌우하는 값이라서 같이 본다.
해법 2: 차등 학습률 (Layer-wise LR)
모델에 완전히 새로운 입력을 추가할 때는 상황이 조금 다르다. 이미지 입력(pixel_values)을 도입할 때가 그랬다.
텍스트/레이아웃 인코더 → 수백 건 문서로 학습되어 이미 수렴한 상태
이미지 인코더          → 이 태스크를 한 번도 배운 적 없는 상태
한 모델 안에 "이미 잘하는 부분"과 "이제 막 배우는 부분"이 함께 있다. 학습률 하나로 전체를 학습시키면 어느 쪽이든 망가진다.
| 학습률 | 이미 수렴한 부분 | 새로 배우는 부분 |
|---|---|---|
| 작게 | 안정적으로 유지 | 너무 느려 수렴 못 함 |
| 크게 | 최적점에서 밀려나 성능 하락 | 빠르게 학습 |
그래서 부분마다 다른 학습률을 줬다.
LR_EXISTING = 1e-5   # 이미 수렴한 부분: 작게 (기존 능력 보존)
LR_NEW      = 5e-5   # 새로 배우는 부분: 크게 (빠른 수렴)

NEW_MODULE_KEYWORDS = ["patch_embed"]

new_params      = [p for n, p in model.named_parameters()
                   if any(kw in n for kw in NEW_MODULE_KEYWORDS)]
existing_params = [p for n, p in model.named_parameters()
                   if not any(kw in n for kw in NEW_MODULE_KEYWORDS)]

optimizer = AdamW([
    {"params": existing_params, "lr": LR_EXISTING, "weight_decay": 0.01},
    {"params": new_params,      "lr": LR_NEW,      "weight_decay": 0.01},
])
역전파는 모델 전체에 한 번 수행되지만, 가중치를 갱신할 때 그룹마다 다른 보폭을 쓴다. 배율은 이론으로 정해지는 값이 아니라 경험칙 범위에서 고르고 실측으로 확인했다. 2배 이하면 새 부분이 몇 epoch 안에 학습되지 않고, 10배 이상이면 새 모듈의 gradient가 공유 레이어까지 흔든다.
작게 실패하고 크게 성공하기
이미지 입력 도입은 1차에서 목표에 못 미쳤다. 100건으로 시작했는데 기대한 개선이 나오지 않았다. 원인을 분석한 뒤 데이터를 300건으로 늘린 2차에서 F1 97.73%가 나왔다.
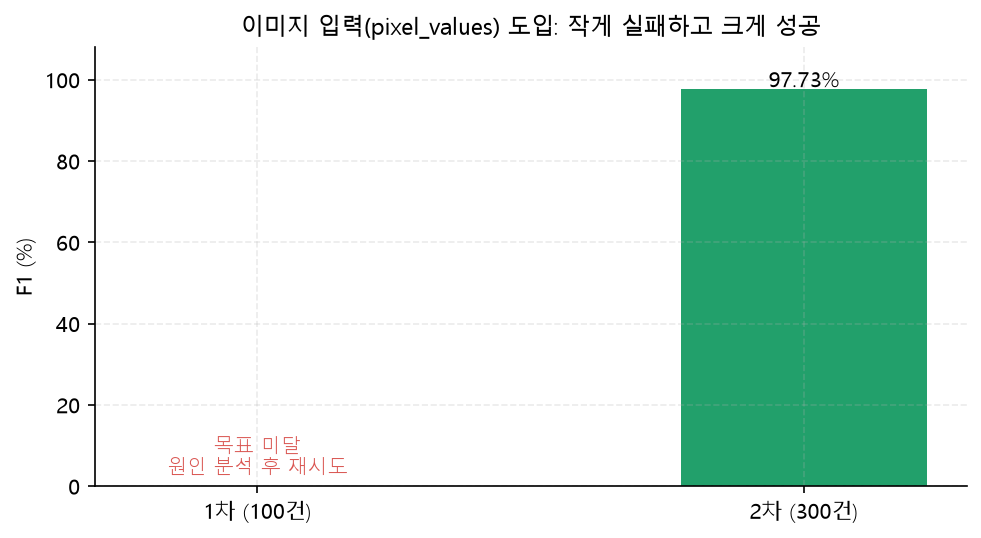
여기서 얻은 부수적인 확인도 있었다. 학습 없이 추론에만 이미지를 추가하면 어떻게 되는지 먼저 테스트했는데, 결과는 이랬다.
이미지 경로 누락: 299/299  → 흰 이미지로 대체
라벨 변경 건수: 0건
confidence 변화: 일부 필드 소폭 하락
처리 시간: +1초
이미지 가중치가 파인튜닝되지 않은 상태에서는 이미지를 넣어도 효과가 없고, 오히려 노이즈였다. 학습부터 포함해야 의미가 있다는 걸 확인하고 재학습으로 넘어갔다.
라운드별 이력
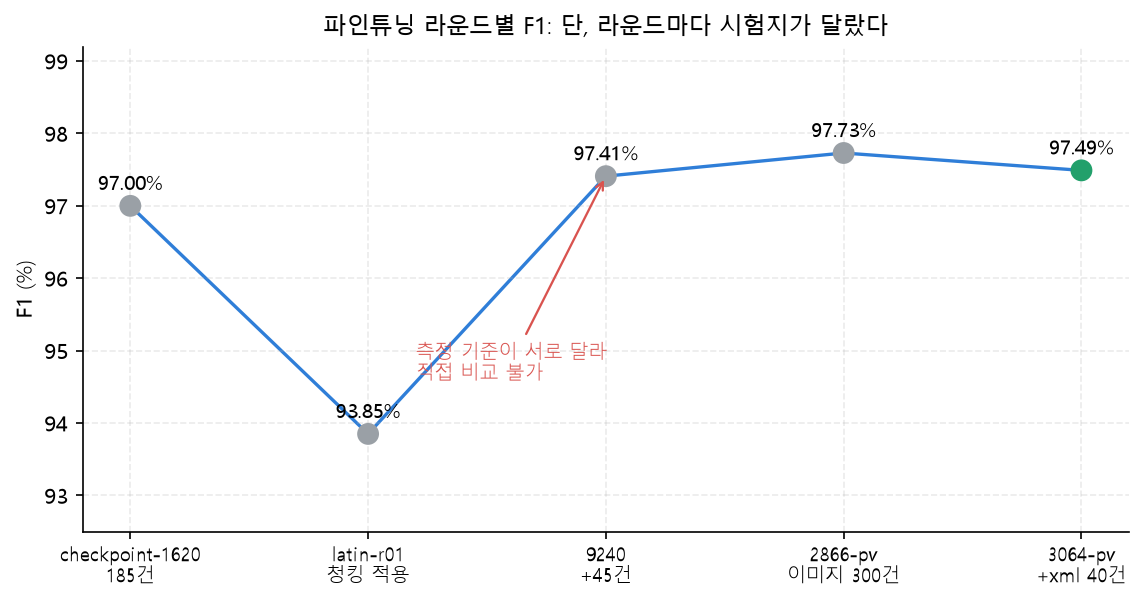
| 체크포인트 | 학습 내용 | F1 |
|---|---|---|
| checkpoint-1620 | 발행처 3곳 인보이스/BL 185건 | 약 97% |
| checkpoint-latin-r01 | 청킹 적용 후 재학습 | 93.85% |
| checkpoint-9240 | 45건 이어학습 | 97.41% |
| checkpoint-2866-pv | 이미지 입력 300건 | 97.73% |
| checkpoint-3064-pv | XML 경로 40건 추가 | 97.49% |
숫자만 보면 오르내림이 있다. 그런데 이 표에는 함정이 있다. 각 라운드의 F1을 그 라운드 학습 데이터의 내부 test split으로 측정했다는 점이다. 라운드마다 시험지가 달랐던 셈이라 직접 비교가 엄밀하지 않다. 이 문제를 어떻게 풀었는지는 고정 벤치마크 글에서 따로 다룬다.
배운 점
"이어서 학습시킨다"는 말이 주는 인상이 위험했다. 당연히 좋아지기만 할 것 같지만, 실제로는 새로 배우는 만큼 무언가를 잃을 위험이 늘 함께 온다. 누적 학습을 기본값으로 정해둔 건 그래서다.
작게 실패할 수 있는 구조가 실제로 도움이 됐다. 이미지 입력 1차가 100건이었기에 실패 비용이 작았고, 원인을 보고 300건으로 다시 갈 수 있었다. 처음부터 크게 갔다면 실패 자체가 더 비쌌을 거다.
학습률 배율처럼 이론으로 안 떨어지는 값은 기록이 답이었다. 왜 1e-5와 5e-5를 골랐는지, 어떤 범위를 시도했는지 남겨두지 않으면 다음 라운드에서 같은 고민을 다시 하게 된다. 이후로는 파라미터를 바꿀 때 선택한 값과 함께 버린 값도 같이 적어 둔다.
새로 배우는 것보다 잃지 않는 게 어려웠다. 라운드를 거듭할수록 관리해야 하는 건 이번 데이터가 아니라 지금까지의 전부였다. 그래서 고정 벤치마크로 매 라운드를 같은 자로 재게 됐고(평가 지표와 고정 벤치마크), 도메인이 늘어날 때 체크포인트를 어떻게 관리할지 검토한 기록이 LoRA를 검토하고 보류한 이유다.
이어 읽기
- LoRA를 검토하고 보류한 이유: 소량 도메인 적응과 운영 비용: 도메인이 늘어날 때의 선택지 검토
- 무엇으로 잘한다고 말할 것인가: 평가 지표와 고정 벤치마크: 망각 여부를 판정한 기준
- 실험을 네 개로 나눈 이유: MLflow로 모델 계보와 비교 가능성을 관리한 기록: 계보와 운영 상태를 MLflow 태그로 관리한 기록
- F1이 세 개였다: 같은 이름으로 다른 것을 재고 있었던 기록: 이어학습 성적을 어떤 채점기로 쟀는지