들어가며
장애가 났을 때 가장 오래 걸리는 구간은 조치가 아니라 어디가 문제인지 좁히는 시간이다. 그리고 그 시간은 구조를 아는 사람이 자리에 있느냐에 따라 크게 달라진다.
이 가이드는 그 편차를 줄이려고 만들었다. 구조를 설명하는 문서가 아니라, 새벽에 알람을 받은 사람이 위에서부터 순서대로 따라가면 원인 범위가 좁혀지도록 쓰는 것이 목표였다.
서비스 구조
[사용자] → DNS (portal.example.com)
            → CloudFront
              ├─ 정적 파일 (S3)
              └─ API 요청 → ALB
                              ├─ /auth/* → ECS auth-service
                              └─ /tax/*  → ECS tax-service
                                            ↕ Service Connect (CloudMap)
                                          ElastiCache Valkey (세션/캐시)
                                          DB EC2
주요 리소스
| 구분 | 리소스 | 비고 |
|---|---|---|
| DNS | 외부 DNS | 도메인 관리 |
| CDN | CloudFront | WAF 연결됨 |
| 프론트엔드 | S3 | 정적 파일 호스팅 |
| 로드밸런서 | ALB | path 기반 라우팅 |
| 백엔드 | ECS Cluster | Fargate, 서비스 2개 |
| 서비스 간 통신 | Service Connect / CloudMap | 내부 도메인 |
| 캐시 | ElastiCache Valkey | 세션/권한 캐시 |
| DB | EC2 기반 MySQL | /data 볼륨 |
| DR | Tokyo 리전 | DLM 스냅샷 CRR (12시간 주기) |
마지막 줄은 숫자의 의미를 알고 봐야 한다. 12시간 주기 복제는 최악의 경우 12시간치 데이터를 잃을 수 있다는 뜻이다. 리전 장애처럼 드문 상황에 대비하는 장치라서 이 수준으로 잡아뒀지만, 요구가 달라지면 주기부터 다시 이야기해야 한다.
모니터링
CloudWatch 대시보드
| 환경 | 대시보드 | 비고 |
|---|---|---|
| Prod | Portal-Prod | 주 모니터링 대상 |
| Staging | Portal-Staging | 개발/테스트용 |
모니터링 항목
| 대상 | 지표 | 정상 기준 |
|---|---|---|
| ECS auth/tax | RunningTaskCount | 1 이상 |
| ECS auth/tax | CPU/Memory | 80% 미만 |
| ALB | 5XX 에러 | 0 |
| ALB | UnHealthyHostCount | 0 |
| ALB | 응답시간 p99 | 5초 미만 |
| CloudFront | 5XX 에러율 | 5% 미만 |
| ElastiCache | EngineCPU | 70% 미만 |
| ElastiCache | Memory | 80% 미만 |
| DB EC2 | CPU | 80% 미만 |
| DB EC2 | 메모리 (CWAgent) | 85% 미만 |
| DB EC2 | 디스크 (CWAgent) | 85% 미만 |
| Service Connect | auth와 tax 사이 5XX | 0 |
항목을 고른 기준은 "이 값이 나빠지면 사용자가 느끼는가"였다. 그래서 요청이 지나가는 경로(CloudFront, ALB, ECS)와 그 경로가 의존하는 자원(캐시, DB)을 짝지어 놓았다. 지표를 많이 만드는 것보다, 계층마다 하나씩 확실한 지표를 두는 편이 장애 때 쓸모가 있었다.
알람 (SNS 알림)
총 알람 수는 서울 22개와 us-east-1(CloudFront) 4개로 26개다.
| 알람 | 의미 | 심각도 |
|---|---|---|
| auth-service-down | auth 서비스 태스크 0개 | Critical |
| tax-service-down | tax 서비스 태스크 0개 | Critical |
| alb-5xx-high | ALB 5XX 에러 급증 | High |
| alb-unhealthy-hosts | ALB 타겟 비정상 | High |
| db-cpu-high | DB CPU 80% 초과 | Medium |
| db-memory-high | DB 메모리 85% 초과 | Medium |
| db-disk-data-high | DB 데이터 디스크 85% 초과 | Medium |
| valkey-memory-high | Valkey 메모리 80% 초과 | Medium |
심각도는 채널과 연결된다. Critical은 즉시 사람을 깨우고, Medium은 업무 시간에 확인한다. 이 기준을 세운 과정은 CloudWatch 알람 기반 통합 모니터링 구축에 정리했다. 알람을 늘리는 것보다 어떤 알람에 어떻게 반응할지를 정하는 쪽이 중요하다.
일일 점검 체크리스트
- CloudWatch 대시보드 확인
- ECS RunningTaskCount 정상
- ALB UnHealthyHostCount 0
- 5XX 에러 없음
- DB 디스크 사용률 정상
- 서비스 URL 접속 확인 (브라우저)
마지막 항목을 빼지 않는 이유가 있다. 모든 지표가 정상인데 사용자는 못 쓰는 경우가 있다. 지표는 우리가 감시하기로 정한 것만 보여주고, 브라우저는 사용자가 실제로 보는 것을 보여준다.
장애 판단 기준
서비스 장애 (Critical)
| 증상 | 판단 기준 | 영향 |
|---|---|---|
| 사이트 접속 불가 | 응답 없음 또는 5XX | 전체 서비스 중단 |
| auth 서비스 다운 | RunningTaskCount = 0 | 로그인과 인증 불가 |
| tax 서비스 다운 | RunningTaskCount = 0 | 세금 관련 기능 불가 |
| DB 접속 불가 | ECS에서 DB 연결 실패 | 전체 서비스 중단 |
auth가 멈추면 tax도 사실상 멈춘다. 권한 조회가 auth와 캐시를 거치기 때문이다(Redis 사용 구조). 무엇이 멈추면 무엇까지 멈추는지는 미리 알고 있어야 영향도 보고가 빨라진다.
성능 저하 (Warning)
| 증상 | 판단 기준 | 영향 |
|---|---|---|
| 응답 느림 | ALB p99 5초 초과 | 사용자 체감 지연 |
| CPU 과부하 | ECS CPU 80% 초과 지속 | 서비스 불안정 |
| DB 디스크 부족 | 데이터 볼륨 85% 초과 | DB 쓰기 실패 위험 |
| 캐시 메모리 부족 | Valkey Memory 80% 초과 | 세션 eviction 발생 |
비상 대응 절차
1단계. 어느 계층인지부터 좁힌다
조치보다 먼저 할 일은 범위를 줄이는 것이다. 요청이 지나가는 순서대로 확인하면 한 번에 한 계층씩 제외할 수 있다.
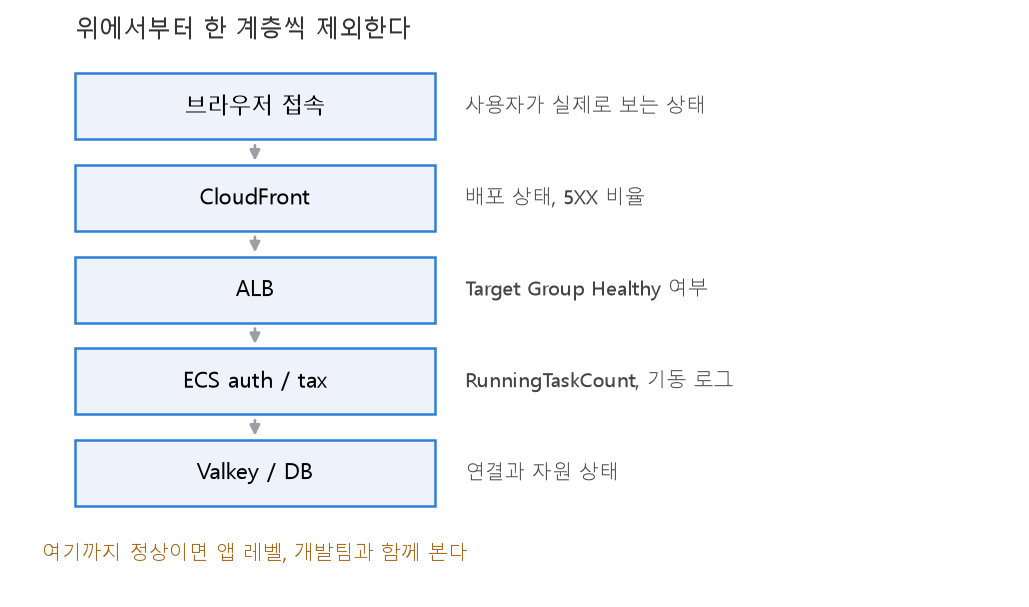
1. 서비스 URL 브라우저 접속 확인
2. CloudFront 상태 확인 (Status: Deployed)
3. ALB 상태 확인 (Target Group Healthy/Unhealthy)
4. ECS 서비스 상태 확인 (auth/tax Running)
5. DB EC2 상태 확인
6. 서비스 다운이면 재기동 절차 진행
| 확인 지점 | 여기서 이상하면 | 아래로 안 내려가도 되는 이유 |
|---|---|---|
| CloudFront 5XX만 높음 | 배포 상태나 캐시 설정 | 오리진은 정상 응답 중일 가능성 |
| ALB UnHealthy | 타겟 또는 헬스 체크 설정 | 앱이 떠 있어도 경로가 안 맞을 수 있다 |
| ECS Task 0개 | 기동 실패, 이미지, 설정 | 로그에 원인이 남는다 |
| Task는 떠 있는데 5XX | 앱 또는 의존 자원(DB, 캐시) | 여기서부터 개발팀과 함께 본다 |
두 번째 줄은 NLB Target Group Unhealthy 문제에서 실제로 겪은 경우다. 통신은 되는데 헬스 체크만 실패하는 상태가 있다.
ECS 서비스 재기동
# 강제 재배포
aws ecs update-service \
  --cluster [cluster-name] \
  --service [service-name] \
  --force-new-deployment \
  --region ap-northeast-2
재기동은 빠른 조치지만 원인을 지운다. 로그와 이벤트를 먼저 확보한 다음에 누른다. 실제로 기동 실패가 반복된 사례(AUTH TOKEN 로테이션 미완료 장애)에서는 재기동만으로는 복구되지 않았고, 원인이 설정 쪽에 있었다.
DB EC2 재기동
aws ec2 reboot-instances \
  --instance-ids [instance-id] \
  --region ap-northeast-2
주의: DB 재부팅 시 ECS 서비스도 일시적으로 영향을 받는다.
ElastiCache Valkey 장애 시
Valkey 장애 시 세션이 초기화되어 사용자 재로그인이 필요하다. 자동 페일오버가 설정되어 있으면 복제본으로 전환된다. 다만 권한 캐시도 같은 클러스터를 쓰기 때문에, 전환 중에는 인증 관련 오류가 함께 나타날 수 있다.
CloudFront와 프론트엔드 장애 시
# CloudFront 캐시 무효화
aws cloudfront create-invalidation \
  --distribution-id [distribution-id] \
  --paths "/*"
에스컬레이션
| 단계 | 담당 | 조건 |
|---|---|---|
| 1차 | 인프라팀 | 모니터링 알람 수신, 인프라 레벨 대응 |
| 2차 | 개발팀 | 앱 레벨 장애, 코드와 배포 관련 이슈 |
| 3차 | 팀 리더 | 1차와 2차 대응이 불가할 때 |
넘기는 기준을 미리 정해두면 "이건 누구한테 물어봐야 하지"를 고민하는 시간이 사라진다. 앞의 계층별 확인표에서 ECS Task는 떠 있는데 5XX가 나오는 지점이 대체로 2차로 넘어가는 경계다.
이 문서가 오래되지 않게
운영 가이드는 만든 다음 날부터 낡기 시작한다. 구조가 바뀌었는데 문서가 그대로면, 장애 때 잘못된 순서를 따라가게 되어 오히려 해가 된다.
- 인프라를 바꾸는 작업의 마지막 단계에 이 문서 갱신을 넣는다
- 실제 장애를 겪으면 그때 확인한 순서를 반영한다
- 분기마다 알람 목록과 실제 알람을 대조한다. 지워진 리소스에 걸린 알람은 영원히 울리지 않는다
배운 점
구조를 아는 것과 장애 때 쓸 수 있는 것은 다르다. 평소에는 머릿속에 있는 구성도가 새벽에는 떠오르지 않는다. 그래서 이 문서는 설명이 아니라 순서로 썼다. 급할 때 읽는 문서는 읽는 사람이 판단할 것을 최대한 줄여야 한다.
대응의 핵심은 조치가 아니라 범위 좁히기다. 재기동 명령은 한 줄이지만, 그 명령을 어디에 써야 하는지 아는 데 시간이 걸린다. 계층별 확인 순서를 표로 만든 이유이고, 이 순서 덕분에 "확인하지 않아도 되는 곳"이 정해진다.
기준을 미리 정해두면 그 시간만큼 빨라진다. 심각도별 채널, 에스컬레이션 경계, 정상 범위 같은 것들은 전부 평소에 정할 수 있는 항목이다. 장애 시간의 상당 부분은 조치가 아니라 판단과 연락에 쓰인다.
실제로 이 구조에서 발생한 장애 기록이 ElastiCache Valkey AUTH TOKEN 로테이션 미완료로 인한 서비스 장애 분석이다. 그 경험에서 나온 항목들이 이 가이드에 반영되어 있다.
이어 읽기
- ElastiCache Valkey AUTH TOKEN 로테이션 미완료로 인한 서비스 장애 분석: 이 구조에서 실제로 발생한 장애
- 사내 통합 포털의 Redis(Valkey) 사용 구조: 서비스가 Redis에 의존하는 지점
- CloudWatch 알람 기반 EC2/ECS 통합 모니터링 구축: 알람 심각도와 채널을 정한 기준