들어가며
문서 추출 모델의 출력을 개발팀에 넘기자 첫 질문이 이랬다.
"라벨이
B-SUPPLIER_NAME으로 오는데, 저희가 B랑 I를 판단해야 하나요?"
당연한 질문이다. 라벨에 접두사가 붙어 있으면, 그걸 받는 쪽이 뭔가 해야 하는 것처럼 읽힌다. 그런데 답은 반대였다. 대부분의 구간에서 개발팀은 BIO를 볼 일이 없다. 문제는 그 경계가 어디인지 아무도 적어두지 않았다는 점이었다.
이 글은 그 경계를 정한 기록이다. BIO가 무엇이고 왜 필요한지, 누가 봐야 하고 누가 몰라도 되는지, 그리고 그 과정에서 같이 정해야 했던 신뢰도 집계 정책까지 정리한다.
한 문장으로
모델은 단어마다 라벨을 붙인다. 여러 단어가 모여 필드 하나가 되기 때문에 그 경계를 표시하는 규칙이 BIO다. API로 주고받는 것은 필드 단위이고, BIO는 그 필드를 만들기 위해 내부에서만 쓴다.
BIO가 무엇인가
B는 Begin, I는 Inside, O는 Outside다.
OCR과 NER을 나눈 구조에서 LayoutLMv3는 토큰 분류 모델이다. 문서를 읽고 단어 하나하나에 라벨을 붙인다. 그런데 필드는 대개 여러 단어로 이뤄진다. 공급자명이 두 줄에 걸쳐 있는 경우를 보자.
ABC Trading Co., Ltd.        → B-SUPPLIER_NAME
15 Sejong-daero, Seoul       → I-SUPPLIER_NAME
모델은 단어 단위로만 판단하기 때문에, 이 두 줄이 "공급자명 두 개"인지 "두 줄짜리 공급자명 하나"인지 구분할 방법이 필요하다. B가 그 구분을 한다. B가 나오면 새 필드가 시작되고, I가 나오면 앞 필드에 이어붙인다.
실제 문서에서 보면 이렇다. 아래는 모델 예측을 Label Studio에 불러온 화면이다.
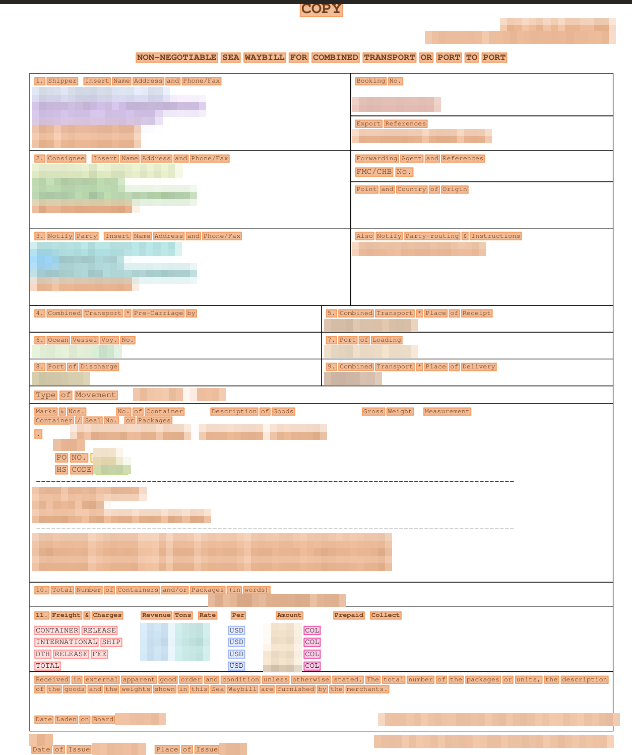
왼쪽 위 송하인, 수하인, 통지처 블록을 보면 여러 줄의 단어 영역이 같은 색으로 칠해져 있다. 모델 입장에서는 이 영역 하나하나가 따로 라벨을 받은 단어들이고, 그중 첫 단어에 B가, 나머지에 I가 붙어 있다. 화면에는 색만 보이지만 그 아래에서 BIO가 "여기부터 여기까지가 한 필드"를 표시하고 있는 셈이다. (식별 정보가 담긴 영역은 모자이크 처리했다.)
B 없이 I와 O만 쓰면 안 되나
B를 쓰지 않고 I와 O만 쓰는 IO 방식도 실제로 쓰인다. 라벨이 절반으로 줄어드니 단순하다. 상용 라벨링 도구 업체의 LayoutLM 인보이스 사례도 IO 방식이었다.
문제는 같은 필드가 연달아 두 번 나올 때다.
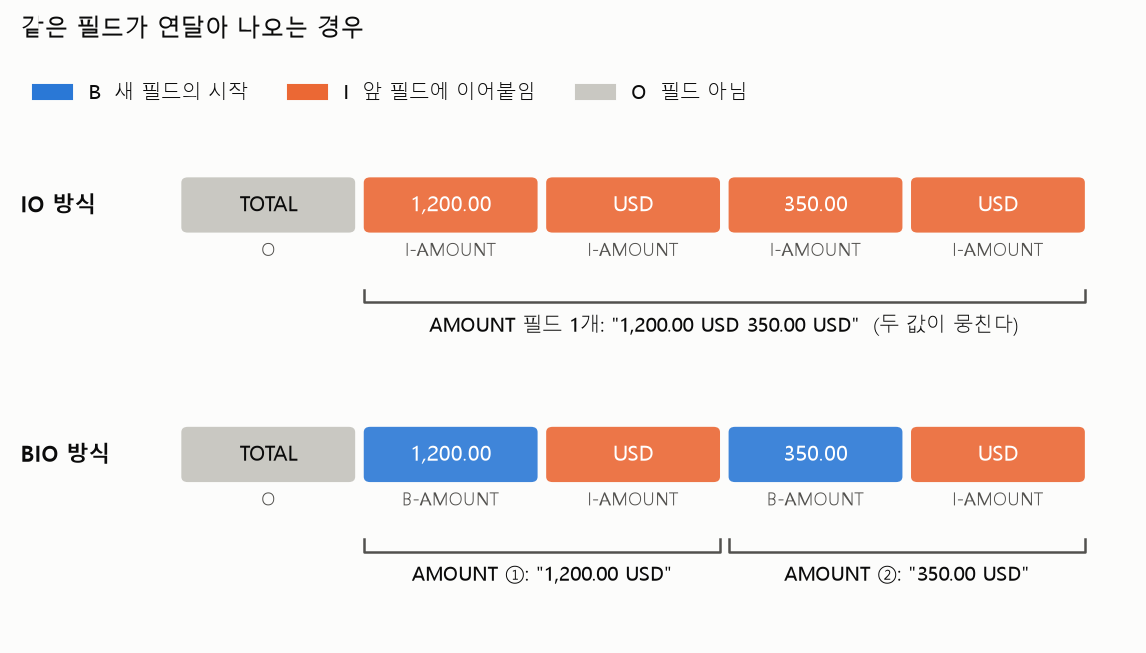
합계가 두 줄로 나뉘어 적히는 문서를 생각해보면 된다. IO 방식에서는 두 금액 사이에 O가 없으니 전부 I로 이어지고, 결과는 "1,200.00 USD 350.00 USD"라는 필드 하나가 된다. BIO에서는 두 번째 금액에 B가 붙어 필드가 둘로 나뉜다.
드문 경우처럼 보이지만 우리 문서에서는 실제로 일어났다. 한 문서 안에 같은 항목이 두 군데 적히거나, 합계 행이 조건별로 두 줄로 나뉘는 양식이 있었다. 그래서 BIO를 쓴다.
30년을 버틴 표기
BIO는 1995년 텍스트 청킹 연구에서 나왔고, 2003년 개체명 인식 공동 과제(CoNLL-2003)를 거치며 사실상 표준이 됐다.
오래 살아남은 이유가 구조에 있다. 괄호로 (공급자명 ... )처럼 범위를 표시하는 방식은 여는 괄호와 닫는 괄호 개수가 안 맞는 출력이 나올 수 있다. 모델이 괄호를 열고 닫는 걸 잊으면 결과를 해석할 수 없다. BIO는 단어마다 태그가 정확히 하나씩 붙으므로 이런 불일치가 구조적으로 생기지 않는다. 틀릴 수는 있어도 해석 못 하는 출력은 나오지 않는다.
문서 추출 분야에서도 같은 방식이 쓰인다. LayoutLM 원 논문의 평가(FUNSD, SROIE)가 전부 BIO 라벨 기준이고, 네이버 클로바 팀은 OCR 결과를 BIO로 태깅해 영수증과 명함을 파싱했다. 라벨 1,000건 미만으로 실서비스 수준의 파서를 만들었다고 밝혔는데, 소량 학습으로 새 양식에 적응한 경험과도 결이 같다.
누가 BIO를 봐야 하는가
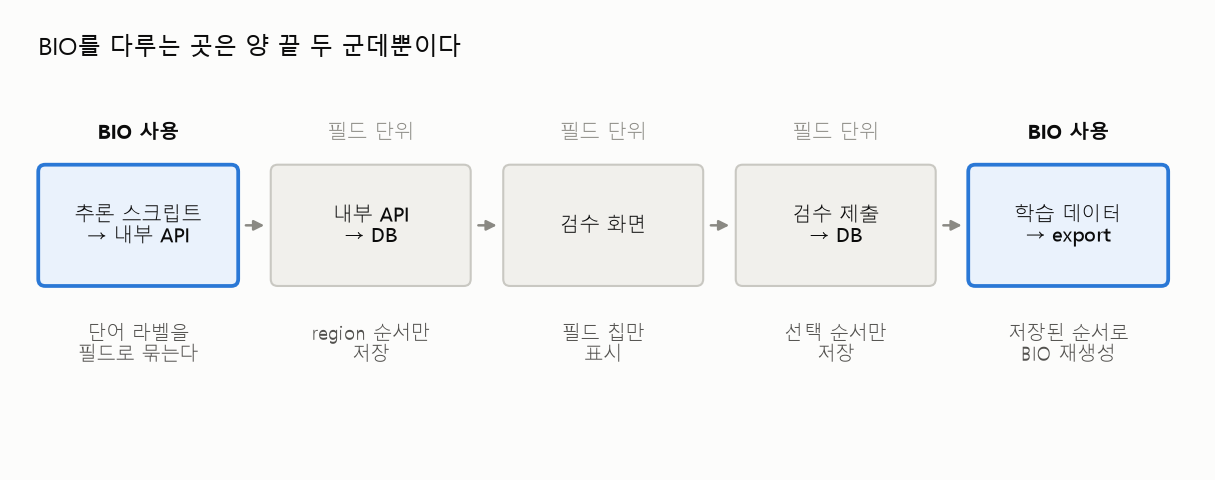
처음 질문으로 돌아가자. 파이프라인을 구간별로 나눠보면 답이 분명해진다.
| 구간 | BIO를 보나 | 담당 |
|---|---|---|
| 추론 스크립트 → 내부 API | 본다. 필드 단위로 묶어서 보낸다 | 추론 (group_bio_to_fields) |
| 내부 API → DB | 안 본다. region_ids 배열 순서만 저장 | 백엔드 |
| 검수 화면 | 안 본다. 필드 칩만 표시 | 프론트 |
| 검수 제출 → DB | 안 본다. 선택한 region 순서만 저장 | 백엔드 |
| 학습 데이터 export | 본다. 저장된 순서에서 재생성 | 백엔드 |
실제로 BIO를 다루는 코드는 두 군데뿐이다. 추론 결과를 필드로 묶는 곳과, 학습 데이터를 내보낼 때 다시 BIO로 펼치는 곳. 양 끝에서만 BIO가 존재하고, 그 사이는 전부 필드 단위로 흐른다.
이렇게 정리하고 나니 개발팀이 알아야 할 것이 단순해졌다. "BIO는 신경 쓰지 말고 필드 단위로 받으세요. 순서만 지켜서 저장해 주세요." 내부 표현을 밖으로 새지 않게 막는 것이 이 설계의 전부다.
Hugging Face의 토큰 분류 파이프라인에도 같은 생각이 들어 있다. aggregation_strategy 옵션(none, simple, first, average, max)이 바로 B와 I를 하나의 엔티티로 합치는 로직이다. 개발팀이 겪을 "단어별 예측을 어떻게 필드 하나로 합칠 것인가"를 라이브러리도 똑같이 고민해서 옵션으로 정리해 둔 셈이다. spaCy도 내부에서는 더 세분화된 BILUO로 학습하고, 밖으로 내보낼 때는 변환한다. 내부 표현과 외부 계약을 분리하는 것은 이 분야에서 이미 자리 잡은 설계다.
지킨 규칙 두 가지
① BIO를 DB에 저장하지 않는다
region_ids를 읽기 순서(y → x)로 정렬해 저장하고, 필요할 때 첫 번째에 B-, 나머지에 I-를 붙인다.
DB에 저장하는 것:   SUPPLIER_NAME → [region_12, region_13]  (읽기 순서)
필요할 때 만드는 것: region_12 → B-SUPPLIER_NAME
                    region_13 → I-SUPPLIER_NAME
순서만 있으면 BIO는 언제든 다시 만들 수 있다. 그런데 둘 다 저장하면 언젠가 갈라진다. 검수자가 영역 순서를 바꿨는데 BIO는 예전 값으로 남는 상황이 대표적이다. 그러면 학습 데이터에 모순된 라벨이 들어간다. 같은 정보는 한 곳에만 둔다. 파생 가능한 값을 저장하는 순간, 그 둘을 맞추는 일이 새로 생긴다.
② 검수자에게 B와 I를 고르게 하지 않는다
검수자는 영역 여러 개를 선택하고 "공급자명" 칩을 한 번 누른다. 순서 정렬과 B/I 부여는 서버가 한다.
검수자의 일은 "이게 공급자명이다"를 알려주는 것이지 B와 I를 판단하는 것이 아니다. BIO를 화면에 노출하면 필드 하나를 잡는 데 라벨을 두 번 골라야 하고, 잘못 고르는 실수가 생긴다. 그 실수는 그대로 학습 데이터가 된다. 검수에서 고친 값이 다음 학습에 쓰이는 구조에서는, 검수 화면의 실수가 곧 모델의 실수다.
라벨 스키마에서 B/I를 빼는 안은 왜 버렸나
아예 모델의 라벨에서 B/I 구분을 없애는 안도 검토했다. 그런데 이러면 분류 레이어(label head)를 전면 교체해야 한다. 라벨 수가 바뀌면 기존 체크포인트에 이어서 학습할 수 없고, 누적 학습으로 쌓아온 능력을 처음부터 다시 만들어야 한다. 표현을 숨기는 문제를 모델을 바꿔서 풀 이유가 없었다.
BIO를 설명하면 따라오는 질문: 신뢰도
BIO를 설명하면 반드시 다음 질문이 나온다. "그럼 신뢰도는 필드마다 하나인가요?"
모델은 단어마다 신뢰도를 준다. 한 필드가 단어 세 개면 값도 세 개다. 이걸 하나로 합치는 방식은 모델이 정하는 게 아니라 정책이다.
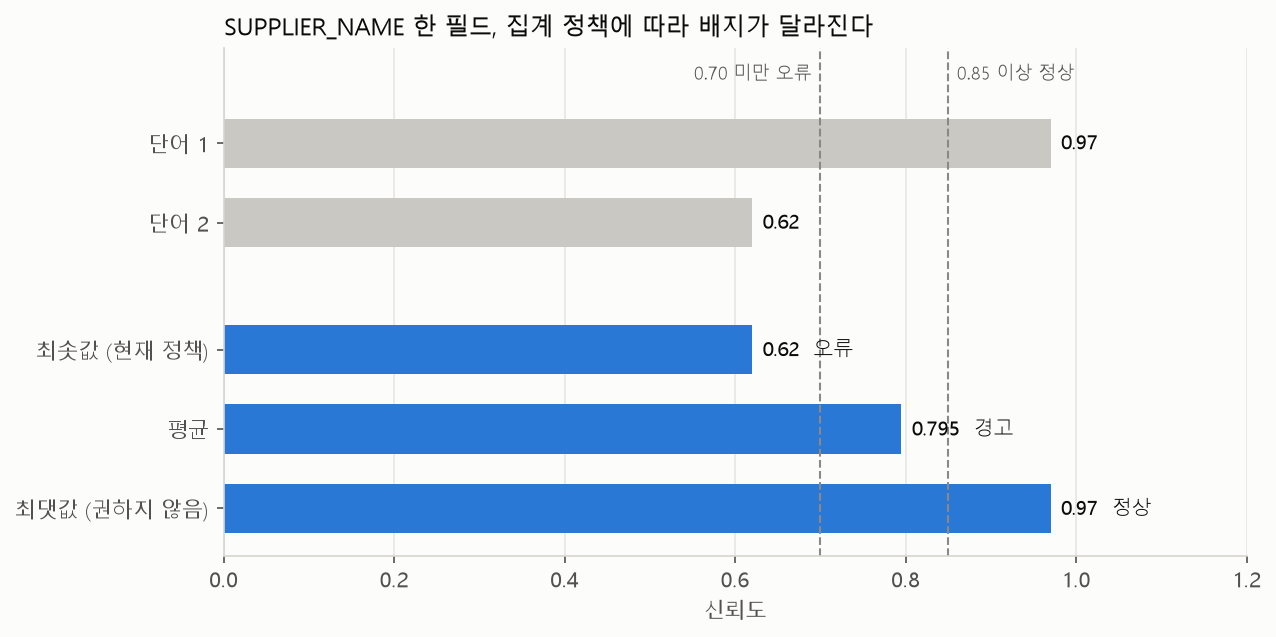
SUPPLIER_NAME의 두 단어가 0.97과 0.62를 받았다고 해보자. 같은 예측인데 무엇으로 합치느냐에 따라 결과가 완전히 달라진다.
| 방식 | 필드 점수 | 배지 | 의미 |
|---|---|---|---|
| 최솟값 | 0.62 | 오류 | 가장 불안한 단어를 필드 점수로 본다 |
| 평균 | 0.795 | 경고 | 전체적인 확신도 |
| 최댓값 | 0.97 | 정상 | 가장 확신한 단어 기준. 권하지 않는다 |
현재는 최솟값으로 잡았다. 한 단어라도 틀리면 필드 값 전체가 틀리기 때문이다. 공급자명의 두 번째 줄이 틀렸다면 그 필드는 틀린 필드다. 평균을 쓰면 확실한 단어가 불확실한 단어를 가려버리고, 검수자는 확인해야 할 필드를 지나친다. 이 판단은 화면에 보이는 점수를 정의할 때의 기준과 같다. 검수는 틀린 것을 찾는 작업이다.
집계는 모델 밖에서
한 가지 더 정한 게 있다. 추론 스크립트는 단어별 값을 그대로(token_confidences) 보내고, 집계는 백엔드가 한다.
추론 스크립트:  predicted_fields + token_confidences [0.97, 0.62]
백엔드:        정책(최솟값)을 적용해 필드 점수 0.62 계산
정책이 바뀌어도 모델을 다시 돌릴 필요가 없게 하려는 것이다. 최솟값이 너무 엄격하다는 의견이 나와서 평균으로 바꾼다고 해도, 백엔드 설정만 고치면 된다. 판단이 자주 바뀌는 것은 계산하기 쉬운 쪽에 둔다. 원본(단어별 값)을 보내고 요약은 받는 쪽에서 하는 구조가 그걸 가능하게 한다.
평가도 필드 단위로
BIO를 쓰면 평가 방식도 같이 따라온다. 토큰 정확도(단어별로 라벨이 맞았는가)는 이 분야에서 거의 의미가 없다. 문서의 단어 대부분이 O라서, 전부 O라고 찍어도 정확도가 높게 나온다.
그래서 seqeval처럼 필드 단위로 맞았는지를 보는 entity-level F1을 쓴다. B와 I로 묶인 범위가 정답 범위와 정확히 일치해야 맞은 것으로 센다. 경계가 한 단어만 어긋나도 틀린 필드다. 사용자가 실제로 받는 것이 필드이니, 평가도 필드로 해야 체감과 맞는다. 양식과 언어로 나눠 테스트할 때 기록한 F1도 전부 이 기준이다.
코드를 새로 쓸 때 가장 먼저 볼 곳
BIO를 필드로 묶는 코드에는 흔한 함정이 하나 있다. 라벨 접두사를 떼는 처리를 빠뜨리는 것이다.
접두사를 떼지 않으면:
  B-INVOICE_NO, I-INVOICE_NO  → 서로 다른 두 필드로 갈라진다
  필수 필드 목록 ["INVOICE_NO", ...]과 비교 → "B-INVOICE_NO" ≠ "INVOICE_NO" → 미검출
이 글을 정리하다가 실제로 이 함정에 걸린 코드를 찾았다. 품질 점수를 계산하는 함수 하나가 필수 필드 목록을 접두사 없이 비교하고 있었다. 모델이 B-INVOICE_NO로 제대로 예측해도 INVOICE_NO와 맞지 않으니 누락으로 잡힌다. 그러면 품질 점수는 실제보다 낮게, 누락 필드는 과하게 기록된다.
에러가 나지 않는 버그라서 발견이 늦다. 로그의 품질 등급이 대부분 가장 낮은 등급으로 찍혀 있는지 보면 바로 드러나는데, 그걸 보려는 사람이 없으면 계속 남는다. 청크 계산이 조용히 틀려 있던 버그와 같은 종류다. 공용 집계 모듈은 BIO 라벨과 접두사 없는 라벨을 모두 받도록 만들어 뒀고, 이 함수는 그 기준에 맞춰 확인할 대상으로 남겨뒀다. 집계 코드를 새로 쓴다면 가장 먼저 확인할 지점이다.
설명하는 방법도 정했다
이 내용을 개발팀에 공유할 때 논문 목록을 길게 나열하지 않기로 했다. 그러면 오히려 "복잡한 연구 이야기"로 들린다. 세 가지면 충분했다.
- 같은 문제를 푼 사례: 국내 팀이 영수증 파싱에 BIO를 써서 적은 라벨로 실서비스를 만들었다
- 이미 쓰는 라이브러리에 들어 있다: Hugging Face의
aggregation_strategy가 같은 일을 한다 - IO와 BIO 한 줄 비교: 같은 필드가 연달아 나오면 B가 있어야 나뉜다
"표준인가요?"라는 질문에 논문으로 답하는 것보다, **"이미 우리가 쓰는 코드가 그렇게 돌아갑니다"**가 훨씬 설득력이 있었다. 구간별 표 하나와 두 줄짜리 예시만 화면에 띄우고, 나머지는 질문이 나오면 답했다.
정리
- 모델은 단어마다 라벨을 붙이고, BIO는 여러 단어를 필드 하나로 묶기 위한 경계 표시다
- IO 방식은 같은 필드가 연달아 나오면 구분하지 못한다. 실제 문서에서 이 경우가 있어 BIO를 쓴다
- BIO를 다루는 곳은 추론 결과 묶기와 학습 데이터 export 두 군데뿐이다. 나머지는 필드 단위로 흐른다
- DB에는 영역 순서만 저장하고 BIO는 필요할 때 만든다. 검수자는 B와 I를 고르지 않는다
- 필드 신뢰도는 단어별 값의 최솟값으로 잡고, 집계는 모델 밖(백엔드)에서 한다
- 필드로 묶는 코드에서는 라벨 접두사 제거를 가장 먼저 확인한다
배운 점
좋은 설계는 알아야 할 사람을 줄인다. BIO는 모델에게는 꼭 필요한 표현이지만, 검수자와 대부분의 개발자에게는 몰라도 되는 내부 사정이다. "누가 이걸 알아야 하는가"를 구간별로 나눠 적고 나니, 공유해야 할 내용도 "필드 단위로 받고 순서만 지켜주세요" 한 줄로 줄었다. 설명이 길어진다면 경계가 제대로 그어지지 않았다는 신호일 수 있다.
파생 가능한 값은 저장하지 않는다. 순서만 있으면 BIO는 언제든 다시 만들 수 있다. 둘 다 저장하는 순간 둘을 맞추는 일이 생기고, 그 일은 언젠가 빠진다. 같은 원칙을 인프라에서도 봤다. Secrets Manager와 ElastiCache 토큰이 따로 관리되다 어긋난 장애가 정확히 이 모양이었다.
자주 바뀔 판단은 바꾸기 쉬운 곳에 둔다. 신뢰도 집계 정책을 모델 밖으로 뺀 건, 그 정책이 틀릴 수 있다는 걸 인정했기 때문이다. 처음부터 정답을 고르는 것보다, 틀렸을 때 싸게 고칠 수 있는 구조를 만드는 편이 현실적이었다.
설득은 권위보다 이미 쓰고 있는 것에서 나왔다. 논문 여러 편보다 "우리 라이브러리에 이미 들어 있다"는 한 줄이 더 빨리 통했다. 새로운 걸 도입하자고 할 때보다, 이미 하고 있는 걸 설명할 때 사람들은 덜 경계한다.
참고 자료
- Ramshaw & Marcus, 1995. Text Chunking using Transformation-Based Learning: IOB 표기의 원전
- CoNLL-2003 Shared Task: 개체명 인식 표준 벤치마크
- Tjong Kim Sang & Veenstra. Representing Text Chunks: 괄호 대신 태그 표기를 쓰는 이유
- Hwang et al., 2019. Post-OCR Parsing via BIO Tagging: OCR 결과를 BIO로 파싱한 사례 (NeurIPS 2019 Document Intelligence Workshop)
- LayoutLM (Microsoft): FUNSD, SROIE 평가를 BIO 라벨로 수행
- BROS (AAAI 2022): BIO의 한계를 지적하고 대안을 제시한 논문
- Hugging Face token_classification pipeline:
aggregation_strategy구현 - spaCy BILUO 논의: 내부 표현과 외부 표현을 분리하는 설계
이어 읽기
- 양식, 언어, 입력 형태로 나눠 테스트한 이유: BIO 태깅을 처음 도입해 표의 행 경계를 모델이 학습하게 만든 과정
- 무엇으로 잘한다고 말할 것인가: 평가 지표와 고정 벤치마크: 필드 점수를 최솟값으로 정한 같은 기준
- OCR과 NER을 왜 나눴나: 문서 AI 파이프라인 모델 선정: 토큰 분류 모델을 고른 배경
- AI 사전상담 에이전트를 설계하고, 직접 만들지 않기로 한 이유: 모델에게 셀 수 있는 일을 맡기지 않은 LLM 에이전트 설계
- F1이 세 개였다: 같은 이름으로 다른 것을 재고 있었던 기록: BIO를 유지한 채점과 떼어낸 채점이 다른 점수를 주는 이유
- 실험을 네 개로 나눈 이유: MLflow로 모델 계보와 비교 가능성을 관리한 기록: 이 필드 정책이 어느 실험에 어떻게 기록되는지