들어가며
B2B 솔루션은 고객이 스스로 "이게 우리 회사에 맞는가"를 판단하기 어렵다. 우리 EDI 서비스도 그랬다. 홈페이지 방문자는 "우리 ERP랑 연동이 되나?" 같은 질문을 품고 들어왔다가, 문의 양식 앞에서 그냥 나갔다. 양식을 채운 고객에게는 영업 담당자가 초기 상담부터 시간을 들여야 했다.
그래서 문의 양식을 AI와의 대화로 바꿔보기로 했다. 대화로 고객의 상황을 파악하고, 대화가 끝나면 영업 담당자가 바로 쓸 수 있는 분석 리포트를 자동으로 만드는 사전상담 에이전트다.
결론부터 적으면, 설계와 PoC까지 마친 뒤 직접 만들지 않기로 했다. 최종적으로는 채널톡 연동으로 배포했다. 이 글은 무엇을 만들었고, 거기서 무엇을 배웠고, 왜 방향을 바꿨는지에 대한 기록이다.
무엇을 만들려 했나
기존의 양식 입력 방식을 AI와의 대화로 대체해 잠재 고객의 니즈를 수집하고, 대화가 끝나면 BANT 분석 리포트와 미팅 플랜을 자동으로 생성하는 사전상담 시스템.
BANT는 영업에서 쓰는 네 가지 판단 기준이다. 예산(Budget), 결정 권한(Authority), 필요(Need), 도입 시점(Timeline). 영업 담당자가 첫 통화에서 파악하려는 것들을 AI가 대화로 먼저 모아두는 셈이다.
설계하면서 가장 먼저 정한 건 포지셔닝이었다. 이 챗봇은 **"리드를 모으는 도구"가 아니라 "서비스가 맞는지 확인해주는 도구"**여야 한다. 고객 입장에서 연락처부터 달라는 챗봇과, 내 상황에 맞는지 같이 따져주는 챗봇은 완전히 다르게 느껴진다. 이 관점이 이후 프롬프트와 화면 흐름을 정하는 기준이 됐다.
출발점은 AWS가 공개한 오픈소스 샘플 PreChat이었다. 이 구조를 가져와 우리 서비스에 맞게 설계를 조정했다.
구조: 두 개의 에이전트
① 프론트엔드            ② 백엔드                  ③ AI 에이전트
(고객/관리자 화면)       (라우팅, 저장, 인증)        (대화와 분석)

React SPA              Lambda + DynamoDB         Strands Agents
CloudFront             API Gateway (WebSocket)   Bedrock AgentCore
                       Cognito
AI 쪽은 역할이 다른 두 에이전트로 나눴다.
| 상담 에이전트 | 요약 에이전트 | |
|---|---|---|
| 언제 | 고객이 메시지를 보낼 때마다 | 대화 종료 후 1회 |
| 입력 | 시스템 프롬프트 + 대화 히스토리 + 현재 메시지 | 전체 대화 로그 |
| 출력 | 실시간 스트리밍 응답 | BANT 리포트 + 미팅 플랜 (JSON) |
| 호출 | WebSocket + SSE 스트리밍 | 동기 호출 |
| 프롬프트 | 관리자가 작성 | 내부 고정 |
대화 흐름은 이렇다. 고객 메시지가 들어오면 Lambda가 캠페인에 설정된 지침과 지금까지의 대화 기록을 모아 에이전트에 넘긴다. 에이전트가 답을 스트리밍하면 그대로 고객에게 흘려보내고 DynamoDB에 저장한다. 대화가 끝나 세션 상태가 바뀌면 DynamoDB Streams가 요약 에이전트를 깨운다. 리포트 생성은 고객이 기다릴 필요가 없는 일이라, 대화 경로에서 떼어내 이벤트로 처리했다.
LLM의 "기억"은 환상이다
설계하면서 팀에 가장 많이 설명한 부분이다. AI가 "아까 자동차 부품 회사라고 하셨죠"라고 말하면 기억하는 것처럼 보이지만, LLM은 아무것도 저장하지 않는다. 매 호출마다 전체 대화를 처음부터 다시 읽는다.
고객이 메시지를 보낼 때마다:
1. Lambda가 이 세션의 전체 대화 기록을 조회
2. 시스템 프롬프트 + 전체 히스토리 + 현재 메시지를 조립
3. 통째로 모델에 전달
4. 모델이 전체를 읽고 응답 생성
5. 응답을 다시 저장
이걸 이해하면 설계에서 두 가지가 따라 나온다. 대화가 길어질수록 매 턴의 입력 토큰이 커지고, 그만큼 비용이 는다. 그리고 앞쪽에 적힌 지침은 대화가 길어질수록 상대적으로 묻힌다. 뒤에 나올 비용 제어와 프롬프트 구조가 모두 이 성질에서 출발한다.
품질은 코드가 아니라 프롬프트에서 나왔다
이 시스템에서 모델은 따로 학습시킨 것이 아니다. 상용 모델을 그대로 쓰고, 파인튜닝도 없다. 그러니 우리가 손댈 수 있는 품질 요소는 거의 전부 **시스템 프롬프트(Agent Instructions)**였다. 코드는 한 줄도 바꾸지 않고 프롬프트만 바꿔도 AI의 행동이 완전히 달라졌다.
문서 모델을 직접 학습시켜 온 입장에서는 낯선 경험이었다. 문서 AI 쪽에서는 행동을 바꾸려면 데이터를 모으고 다시 학습해야 했는데, 여기서는 문장 몇 줄이 그 역할을 했다.
모델이 요금을 지어냈다
테스트 중 고객 역할로 "대략적인 비용이 어느 정도 되나요?"라고 물었다.
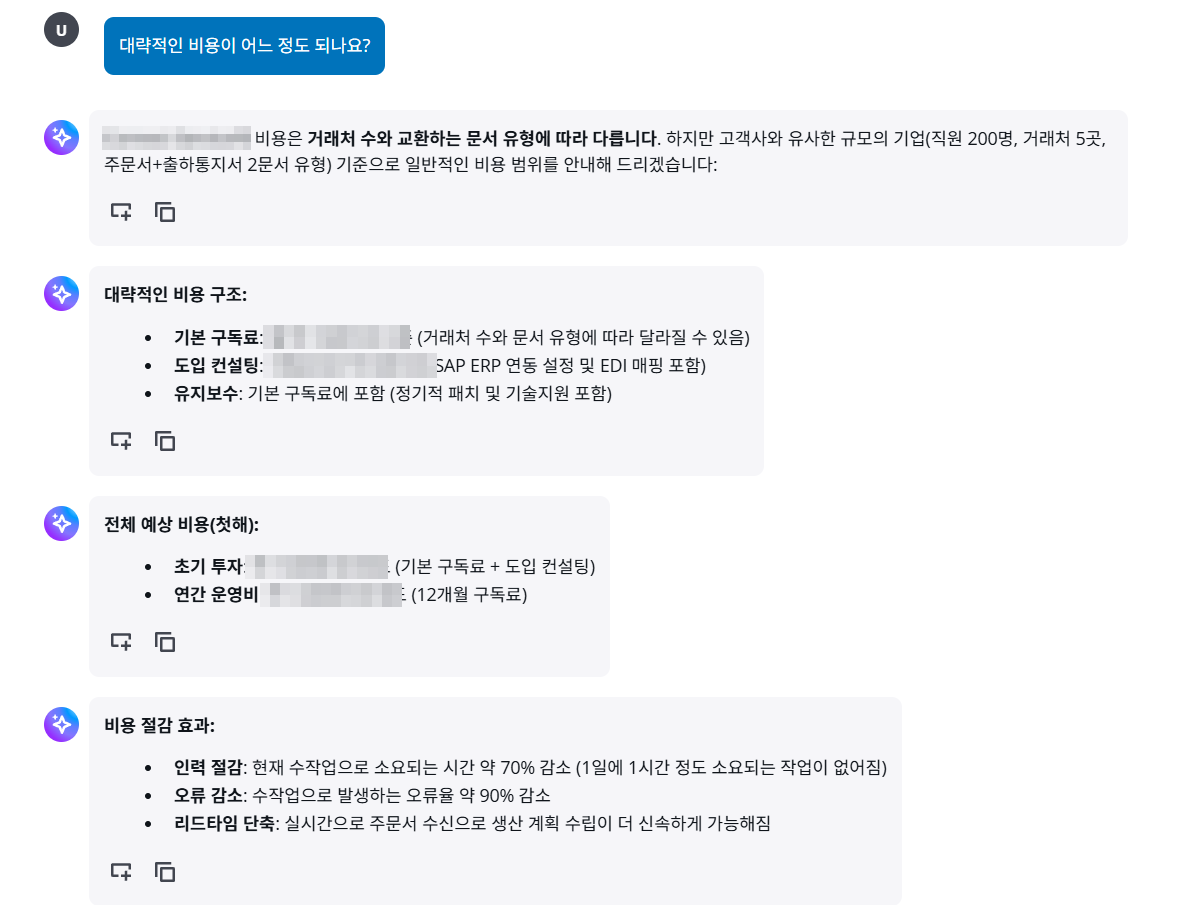
"월 약 150만 원", "초기 투자 약 7,000만 원", "인력 약 70% 감소". 전부 지어낸 숫자다. 실제 요금과 아무 관계가 없고, 모델이 사전 학습한 일반 지식으로 그럴듯하게 추론한 값이다. 영업 상담에서 이런 숫자가 나가면 이후 실제 견적이 전부 이 숫자와 비교당한다. 틀린 답보다 더 곤란한 종류다.
원인은 세 가지였다.
| 원인 | 설명 |
|---|---|
| 금지 지침이 약했다 | "정확한 금액을 제시하지 마세요"를 모델은 "대략적인 범위는 괜찮다"로 해석했다 |
| 금지 지침이 아래에 있었다 | 대화가 길어질수록 하단 지침의 영향력이 떨어진다 |
| 위반 예시가 없었다 | 어떤 답이 위반인지 모델이 판단할 기준이 없었다 |
약한 지시와 강한 지시
[약한 지시, 잘 안 지켜짐]
- 정확한 금액을 제시하지 마세요.

[강한 지시, 잘 지켜짐]
절대 금지 - 비용/가격 관련:
- 어떤 상황에서도 구체적인 금액, 가격 범위, 예상 비용을 언급하지 마세요.
- "약 OO만원", "OO원 수준", "OO만원~OO만원" 등 숫자가 포함된 비용 안내 절대 금지.
- 고객이 비용을 물어보면 반드시 다음과 같이만 답하세요:
  "비용은 거래처 수, 문서 유형, 연동 범위에 따라 달라집니다.
   1:1 컨설팅에서 정확한 견적을 안내드리겠습니다."
- 비용 절감 효과(%)도 구체적 수치로 언급하지 마세요.
- 위반 예시: "월 약 150만원", "초기 투자 7,000만원", "70% 감소"
- 올바른 답변 예시: "비용은 환경에 따라 다르므로 컨설팅에서 안내드리겠습니다."
이 블록을 프롬프트 맨 위로 올리고 다시 물었다.
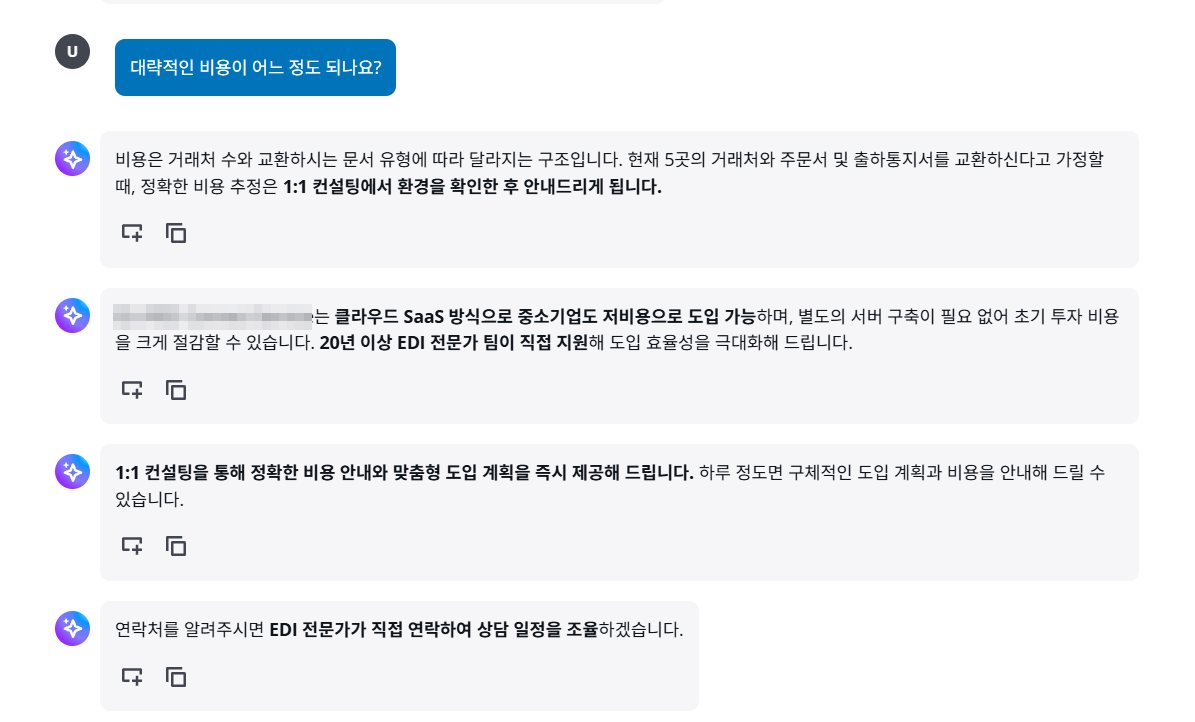
금액이 사라졌고, 고객의 상황(거래처 5곳, 주문서와 출하통지서)을 받아 컨설팅으로 연결하는 흐름이 됐다. 같은 방식으로 다른 문제도 고쳤다.
| 문제 | 프롬프트 수정 | 결과 |
|---|---|---|
| 금액을 지어냄 | 위반 예시 + 올바른 답변 템플릿 추가 | 금액 언급 중단 |
| 질문을 한 번에 세 개씩 함 | "하나씩"을 "절대 2개 이상 금지"로 | 한 번에 하나씩 질문 |
| 서비스 기능을 장황하게 나열 | "수집이 목적이지 설명이 목적이 아니다" 추가 | 짧은 응답 |
여기서 정리한 원칙은 다섯 가지다.
- 구체적일수록 잘 지킨다. "짧게 답하세요"보다 "3~4문장 이내로 답하세요"
- 금지는 위반 예시와 함께. 하지 말라는 말만으로는 경계가 모호하다
- 중요한 것은 위에. 앞의 "기억은 환상" 절과 같은 이유다
- 예시가 규칙보다 강하다. 모범 답변 두세 개가 규칙 열 줄보다 효과가 컸다
- 한 번에 완벽한 프롬프트는 없다. 테스트하고 고치는 반복이 전부다
셀 수 없는 것은 모델에게 맡기지 않는다
"대화가 8턴을 넘으면 마무리하세요"라고 프롬프트에 적어두면 될 것 같지만, 모델은 턴 수를 정확히 세지 못한다. 앞에서 봤듯 모델은 매번 대화 전체를 새로 읽을 뿐 "지금 몇 번째인가"를 따로 추적하지 않는다.
그래서 세는 일은 백엔드가 한다. Lambda가 저장된 메시지 수를 세고, 기준을 넘으면 시스템 프롬프트에 "지금은 마무리 단계다"라는 문구를 끼워 넣는다. 모델에게는 판단이 아니라 상태를 알려주는 방식이다.
BIO 태깅 글에서 신뢰도 집계를 모델 밖으로 뺀 것과 같은 판단이다. 모델이 잘하는 일(문장 생성)과 코드가 확실하게 하는 일(세기, 비교, 집계)을 나누면 둘 다 안정적이 된다.
비용: 생각보다 싸고, 생각보다 쉽게 터진다
"LLM은 비싸다"는 인상이 팀에 있었다. 실제로 계산해보니 모델 선택에 따라 전혀 다른 이야기였다.
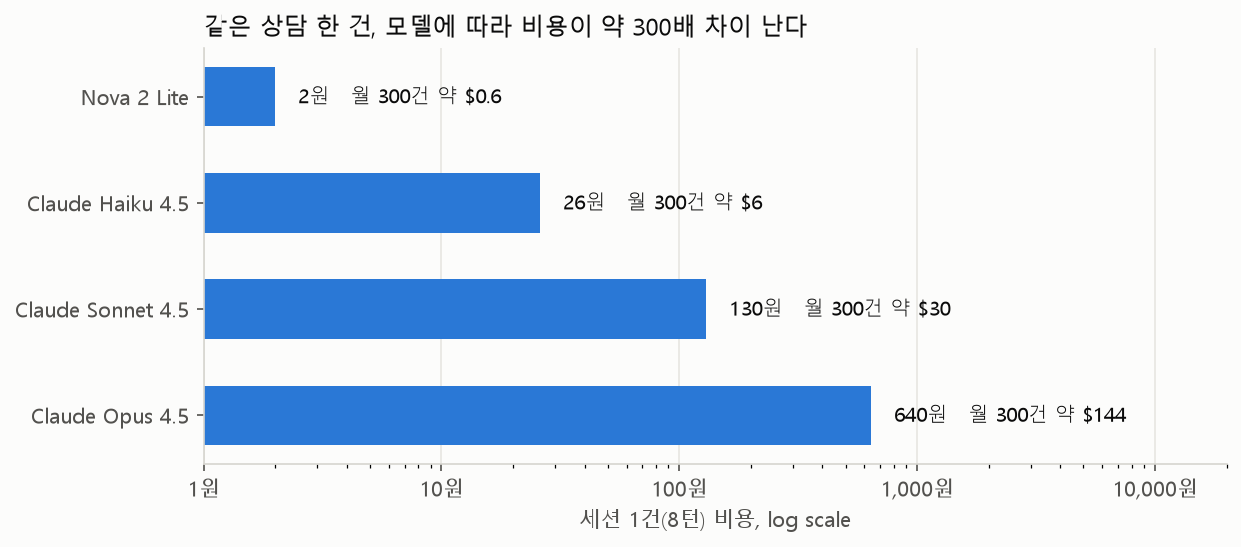
| 모델 | 입력 (1M 토큰) | 출력 (1M 토큰) | 세션 1건 (8턴) |
|---|---|---|---|
| Nova 2 Lite | $0.08 | $0.32 | 약 2원 |
| Claude Haiku 4.5 | $0.80 | $4.00 | 약 26원 |
| Claude Sonnet 4.5 | $3.00 | $15.00 | 약 130원 |
| Claude Opus 4.5 | $15.00 | $75.00 | 약 640원 |
같은 상담 한 건이 2원에서 640원까지 벌어진다. "LLM은 비싸다"는 인식은 대부분 최상위 모델 기준이었다. 역할에 따라 모델을 나누는 게 답이었다. 상담 에이전트는 매 턴 호출되니 가장 가벼운 모델로 고정하고, 대화 종료 후 한 번 도는 요약 에이전트는 리포트 품질을 보며 Haiku에서 시작해 필요하면 올리기로 했다. 월 300건 기준 인프라까지 포함해도 요약을 Haiku로 두면 약 1만 원, Sonnet으로 올려도 5만 원 안팎이다.
그런데 쉽게 터진다
단가가 싸다고 안전한 건 아니다. 대화 기록 전체를 매번 다시 보내는 구조라서, 대화가 길어지면 비용이 턴 수에 비례하는 게 아니라 그보다 빠르게 늘어난다. 여기에 봇이 반복 호출하거나, 고객이 장문을 붙여넣거나, 동시 세션이 몰리면 청구서가 갑자기 커진다.
그래서 제어를 네 겹으로 설계했다.
| 단계 | 방법 | 성격 |
|---|---|---|
| 1. 프롬프트 | "10턴 이내로 마무리하세요" | 보조 수단. 모델이 안 지킬 수 있다 |
| 2. 백엔드 | 턴 수 상한, 세션당 토큰 상한, 입력 길이 제한, 일일 세션 상한 | 핵심. 코드가 강제한다 |
| 3. 인프라 | AWS Budgets 알림, Bedrock 쿼터, CloudWatch 경보, 비용 이상 탐지 | 안전망 |
| 4. 모델 선택 | 경량 모델 고정 | 상한 자체를 낮춘다 |
모든 제어를 걸고 최악의 경우(매일 상한까지 꽉 참)를 계산하면 월 약 $106이 최대치였다. 이 숫자가 있으니 "비용 폭탄 나면 어떡하냐"는 질문에 "최악이 이 정도"라고 답할 수 있었다. NLB 포트 트래픽 확인에서 "없다"를 증명하는 데 관측 기간이 필요했던 것처럼, "안전하다"를 말하려면 상한이 필요했다.
Knowledge Base는 언제 필요한가
RAG를 붙이자는 이야기가 초반부터 나왔다. 그런데 따져보니 이 에이전트에는 필요 없었다.
사전상담 에이전트는 답하는 쪽이 아니라 묻는 쪽이다. 고객에게 질문해서 정보를 모으는 게 목적이라 많은 지식이 필요하지 않다. 대화도 8~10턴이면 끝나서, 8턴 기준 전체 사용량이 약 8,500토큰이었다. 컨텍스트 윈도우 100만 토큰의 1%도 안 된다.
| 챗봇 유형 | AI의 역할 | KB 필요 |
|---|---|---|
| 사전상담 (이번) | 묻는 쪽 | 불필요 |
| 기술 FAQ | 답하는 쪽 (기술 문서 참조) | 필요 |
| 사내 문서 검색 | 답하는 쪽 (사내 문서 전체) | 필수 |
대신 KB가 필요해지는 신호를 적어뒀다. 프롬프트가 3,000자를 넘어갈 때, "확인 후 안내드리겠습니다" 응답이 30%를 넘을 때, 문서가 자주 바뀔 때, 고객이 근거를 요구할 때. KB를 붙인다면 벡터 저장소는 상시 과금되는 OpenSearch Serverless 대신 사용량 과금인 S3 Vectors가 초기 규모에 맞았다. 청킹 방식이 검색 품질을 좌우한다는 점은 LayoutLM 청킹에서 겪은 것과 같은 이야기라서 반가웠다.
사내 발표에서 받은 여덟 가지 질문
설계를 사내 기술 공유 세션에서 발표했고, 피드백을 여덟 건 받았다. 그중 몇 가지는 설계 방향을 바꿨다.
"문의 폼과 정보 문의 채팅을 분리해야 하지 않나?" 맞는 지적이었다. 도입 문의는 AI가 묻는 쪽이고, 기술 문의는 AI가 답하는 쪽이다. 역할이 반대인 두 대화를 한 에이전트에 넣으면 프롬프트가 서로를 방해한다. 진입점에서 먼저 나누는 쪽으로 정리했다.
"경쟁사가 와서 정보만 얻어가면?" 토큰 비용만 쓰고 떠나는 무임승차 문제다. 접근 제한(PIN), 답변 범위 제한, 턴 수 제한, 캠페인별 링크 발급을 조합했다.
"상담 이후 담당자 진행 상황은 어떻게 추적하나?" 리포트 생성 이후의 흐름, 즉 담당자 배정, 미팅, 계약까지의 추적이었다. 이 질문은 그때는 "중기 과제"로 적어뒀는데, 나중에 이게 결정적인 질문이 됐다.
다섯 개 서비스를 직접 써봤다
다른 회사들은 이 문제를 어떻게 풀었는지 보려고, 채널톡, Intercom, Qualified, 아임웹, 네이버 클라우드의 챗봇을 고객 입장에서 직접 대화해봤다.
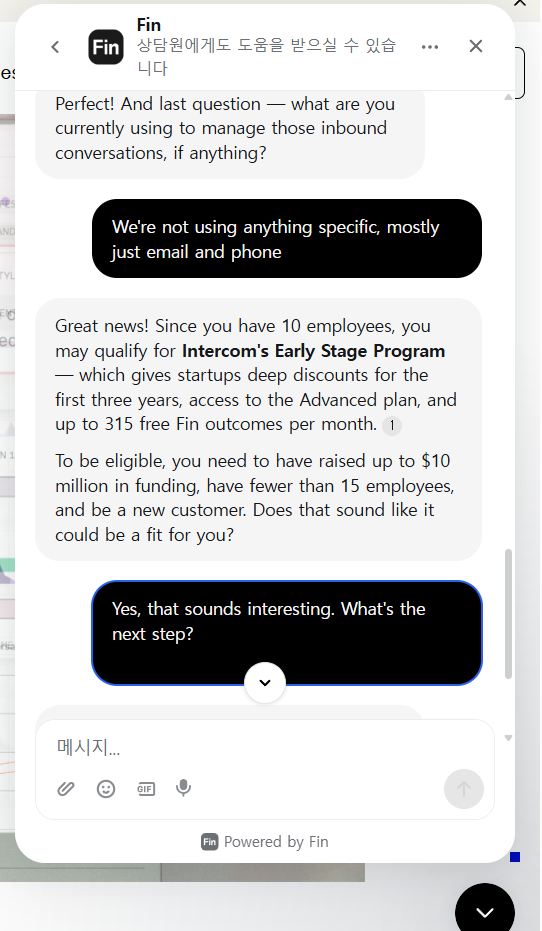
가장 인상적이었던 건 Intercom이었다. 대화 중 직원 수를 듣고 "10명이면 초기 기업 프로그램 대상일 수 있다"며 수집한 정보로 다음 제안을 바꿨다. 단순히 데모로 연결하는 게 아니라 데이터로 라우팅하는 것이다. 이메일도 세 번 요청하는데 매번 명분이 달랐고, 거절하면 순순히 넘어갔다. 마지막 질문 앞에는 "And last question"이라고 예고해 끝이 보이게 했다.
| 서비스 | 가져온 것 |
|---|---|
| 채널톡 | 기존 고객 CS와 신규 도입 상담을 아예 다른 세션으로 분리. 발표 피드백 1번의 실제 구현 사례 |
| Intercom | 수집 데이터 기반 개인화 제안, "마지막 질문" 예고, 명분을 바꾼 연락처 요청 |
| Qualified | 버튼은 핵심 분기점 한 곳에서만. 나머지는 자유 입력 |
| 아임웹 | 검색 중 상태 노출("찾은 정보를 확인하고 있어요"), AI 한계 고지 문구 상시 노출 |
| 네이버 클라우드 | AI 없는 메뉴 라우터. 우리가 대체하려던 구조 그 자체라서 반대 사례로 유용 |
이 중 프롬프트 수정만으로 되는 것(개인화 인사, 마지막 질문 예고, AI 한계 고지)은 바로 반영했다. 직접 써보니 기능 목록으로는 안 보이던 것들이 보였다. 특히 "어디서 버튼을 쓰고 어디서 자유 입력을 받는가"는 대화를 해봐야만 알 수 있는 설계였다.
첫 번째 방향 전환: 연락처를 먼저 받을 것인가
원래 설계의 강점 중 하나는 대화 전에 연락처를 먼저 받는 것이었다. 이름, 회사, 이메일을 폼으로 받고 시작하니, 대화 중에 연락처를 요청하느라 턴을 쓸 필요가 없었다.
그런데 마케팅 팀 검토에서 반대 의견이 나왔다. 홈페이지에 공개되는 챗봇이라면 부담 없이 질문할 수 있어야 한다. 들어오자마자 회사명과 이메일을 요구하면 AI 챗봇의 장점이 사라진다는 것이다.
AI 기본 응대 → 관심사 파악 → 자료 전달 (이메일 확보) → 상담 요청 (회사 정보 확보) → 담당자 인계
정보는 필요한 시점에 자연스럽게 받는 흐름으로 바꿨다. 소개 자료를 받고 싶을 때 이메일을, 상담을 원할 때 회사 정보를 남기게 했다. 다만 이메일 마케팅이나 전시회 QR처럼 대상이 정해진 캠페인 링크에서는 선수집이 여전히 맞다. 같은 기능이라도 어디에 노출되느냐에 따라 정답이 달랐다.
두 번째 방향 전환: 결론이 뒤집힌 이유
발표 피드백에 대응하던 시점에는 직접 구축이 맞다고 판단했다. 근거는 분명했다.
- 기존 사내 시스템과 연동이 필요하다
- B2B 고객의 대화 데이터를 우리가 소유해야 한다
- BANT 리포트 같은 맞춤 후처리가 필요하다
- 향후 다른 에이전트로 확장할 계획이 있다
- AWS 인프라 운영 역량이 팀에 있다
그런데 v1 범위를 산정하면서 발표 때 받았던 그 질문, "담당자 진행 상황은 어떻게 추적하나"가 다시 나왔다. AI가 상담을 받고 리포트를 만드는 것만으로는 서비스가 끝나지 않았다. 리포트가 담당자에게 배정되고, 상담 이력이 쌓이고, 고객 관리 시스템과 이어져야 비로소 영업에 쓸 수 있었다.
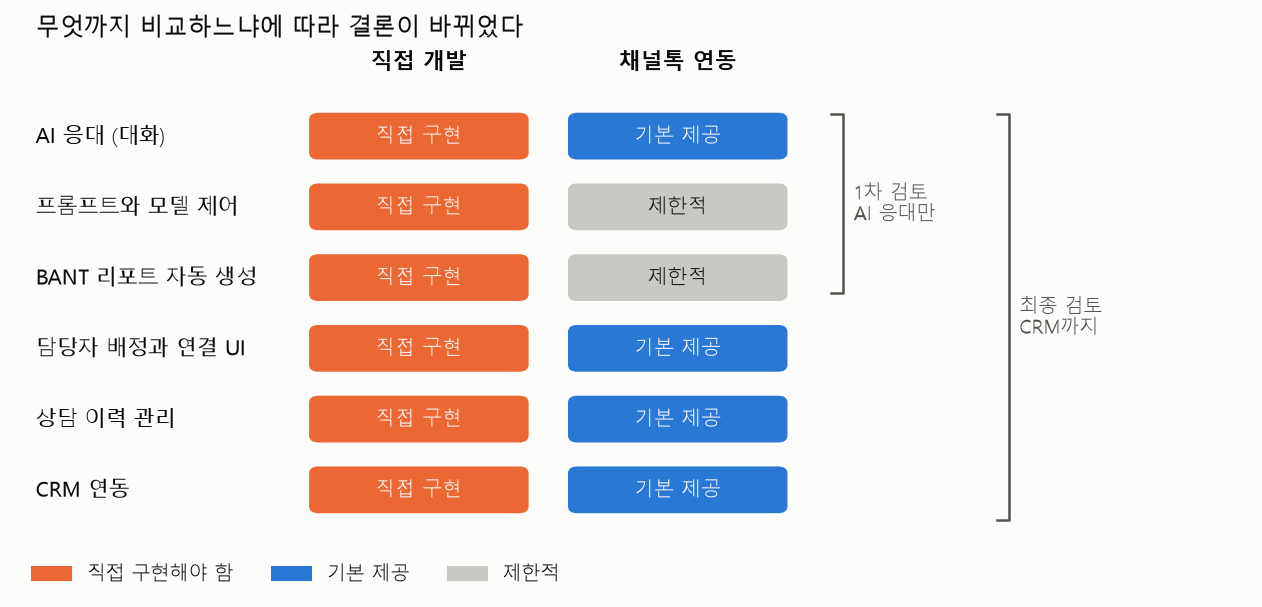
AI 응대 기능만 비교하면 직접 구축이 우세했다. 프롬프트와 모델을 마음대로 바꿀 수 있고, BANT 리포트도 우리가 원하는 대로 만들 수 있다. 그런데 CRM까지 포함해서 비교하니 결론이 뒤집혔다. 담당자 배정, 상담 이력 관리, CRM 연동은 채널톡에 이미 들어 있고, 직접 만들려면 AI와 별개로 고객 관리 시스템을 하나 더 만들어야 했다.
| 1차 검토 | 최종 검토 | |
|---|---|---|
| 비교 범위 | AI 응대 기능만 | AI 응대 + CRM 전체 |
| 결정적 변수 | 커스터마이징, 데이터 소유권 | 담당자 추적 기능의 구현 부담 |
| 결론 | 직접 구축 | 채널톡 연동 |
두 판단은 모순이 아니다. 같은 질문에 다른 범위로 답했을 뿐이다. v1 단계에서는 빠른 배포와 CRM 통합을 동시에 얻을 수 있는 채널톡 연동을 택했고, 실제 사용 패턴을 본 뒤 맞춤 기능이 더 필요해지면 다시 검토하기로 했다. 설계와 PoC는 버려진 게 아니라, 그때 꺼내 쓸 자산으로 남겨뒀다.
정리
- 양식 입력을 AI 대화로 바꾸고, 대화 후 BANT 리포트를 자동 생성하는 사전상담 에이전트를 설계하고 PoC까지 진행했다
- 모델은 상용 모델을 그대로 썼고, 품질은 거의 전부 시스템 프롬프트에서 나왔다. 금지는 위반 예시와 함께, 중요한 것은 위에
- 턴 수처럼 세야 하는 일은 모델이 아니라 백엔드가 한다
- 비용은 모델 선택으로 300배까지 차이 나고, 제어는 백엔드 하드 제한이 핵심이다
- 묻는 쪽 에이전트에는 KB가 필요 없다. 답하는 쪽으로 넓어질 때 필요해진다
- AI 기능만 비교하면 직접 구축, CRM까지 비교하면 솔루션 연동. 최종적으로 채널톡 연동으로 배포했다
배운 점
무엇까지 비교하느냐가 결론을 정한다. 1차 검토와 최종 검토의 결론이 반대였는데, 어느 쪽도 틀리지 않았다. 달라진 건 비교 범위였다. 그래서 기술 선택을 할 때 "무엇이 더 나은가"보다 먼저 "이 서비스가 끝까지 동작하려면 무엇이 더 필요한가"를 묻게 됐다. AI 응대는 서비스의 시작이지 전부가 아니었다. LoRA를 검토하고 보류한 판단도 같은 모양이었다. 기술 자체보다, 그걸 운영하는 데 따라오는 것들이 결정을 바꿨다.
직접 만들 수 있다는 것과 직접 만들어야 한다는 것은 다르다. AWS 역량이 있으니 만들 수 있었고, PoC로 그걸 확인했다. 하지만 만들 수 있다는 사실이 만들 이유가 되지는 않았다. 오히려 PoC가 있었기 때문에 "필요해지면 언제든 다시 만들 수 있다"는 확신을 갖고 솔루션을 택할 수 있었다. 검증이 선택지를 없애는 게 아니라 넓혀준 셈이다.
모델에게는 잘하는 일만 맡긴다. 요금을 지어내는 문제는 프롬프트로 막았지만, 턴 수를 세는 일은 프롬프트로 해결하려 하지 않았다. 모델은 문장을 만드는 데 뛰어나고, 세고 비교하고 강제하는 일은 코드가 확실하다. 이 경계를 긋는 게 LLM을 서비스에 붙일 때 가장 먼저 할 일이라고 생각한다.
발표에서 받은 질문은 나중에 돌아온다. 담당자 추적에 대한 질문은 그때는 중기 과제로 미뤘는데, 결국 방향을 바꾼 결정적인 이유가 됐다. 설계를 일찍 공유한 덕분에 그 질문을 일찍 받았고, 그래서 개발에 들어가기 전에 방향을 바꿀 수 있었다. BIO 태깅 경계를 개발팀과 맞출 때도 비슷했다. 빨리 보여줄수록 틀린 부분도 빨리 드러난다.
참고 자료
- aws-samples/sample-prechat-ai (GitHub): 출발점이 된 오픈소스 샘플
- PreChat 문서, 아키텍처
- PreChat 문서, 보안과 비용 고려사항
- Amazon Bedrock AgentCore 문서
- Strands Agents SDK
이어 읽기
- LoRA를 검토하고 보류한 이유: 소량 도메인 적응과 운영 비용: 기술보다 운영이 결정을 바꾼 또 다른 사례
- B-SUPPLIER_NAME은 누가 봐야 하나: BIO 태깅의 경계를 정한 기록: 모델이 할 일과 코드가 할 일을 나눈 같은 판단
- OCR과 NER을 왜 나눴나: 문서 AI 파이프라인 모델 선정: LLM을 본선이 아닌 보조 수단으로 둔 이유